들어가며
Spring Kafka에 올린 첫 PR이 main 브랜치에 반영되었다.
처음부터 오픈소스에 기여해 보겠다는 생각으로 시작한 일은 아니었다. 코드 배포 후 모니터링하다가, pause되었던 파티션들이 재개 조건을 만족했는데도 다시 resume되지 않는 이상 현상을 발견했다.
처음에는 단순히 내가 작성한 코드에서 문제가 있을 것이라 생각했다. 그런데 로그를 추가하고 코드를 하나씩 따라가다 보니 예상과 다른 값이 Spring Kafka 내부에서 반환되고 있음을 알게되었다. 결국 원인을 파악하기 위해 Spring Kafka 라이브러리의 내부 구현까지 읽게 되었고, 그 과정에서 원인으로 의심되는 부분을 찾을 수 있었다.
그저 멈춰 있는 Consumer를 다시 동작시키고 싶어서 시작한 디버깅이, 그렇게 첫 오픈소스 기여로 이어졌다.
이번 글에서는 문제가 되었던 코드부터 ConcurrentMessageListenerContainer의 구조, 버그의 원인, 그리고 Spring Kafka에 코드를 기여하기까지의 과정을 정리해 보려고 한다.
지옥의 디버깅 시작
재개되어야 할 파티션이 계속 멈춰있다
문제가 된 코드를 핵심 부분만 단순화하면 다음과 같다.
// resume 대상 파티션들 중에서 실제 pause 요청을 받은 파티션 선별
val pausedPartitions = candidates.filter { partition ->
    container.isPartitionPauseRequested(partition)
}

// 선별된 파티션들 resume
pausedPartitions.forEach { partition ->
    container.resumePartition(partition)
}
위에서의 candidates 변수는 애플리케이션에서 재개 조건을 만족한다고 판단한 파티션 목록이다. 이 중 실제로 pause 요청이 남아 있는 파티션만 골라 resumePartition()을 호출하고 있었다. 코드만 보면 특별히 이상한 부분은 없어 보였다. pause 요청을 확인하고, 요청이 남아 있다면 resume을 호출하는 구조이기 때문이다.
그런데 실제 배포 후 확인해 보니, 분명 pause된 파티션이 존재하고 재개 조건도 만족했는데 소비가 다시 시작되지 않았다. 처음에는 resumePartition()이 제대로 동작하지 않는다고 생각했다. 하지만 로그를 추가하며 코드를 따라가 보니 조금 다른 문제가 보였다.
container.isPartitionPauseRequested(partition)이 값이 계속 false를 반환하고 있었다. 그 결과 pausedPartitions가 빈 목록이 되었고, 아래의 resumePartition()까지 도달하지 못했다.
즉 문제는 resumePartition()이 실패하는 것이 아니었다. 즉, resumePartition() 자체가 호출되지 않고 있었다.
그렇다면 다음 질문은 자연스럽게 정해졌다. 분명 pause했던 파티션인데, 왜 isPartitionPauseRequested()는 false를 반환할까?
이 문제를 이해하려면 먼저 Spring Kafka의 ConcurrentMessageListenerContainer가 어떤 구조로 동작하는지 알아야 한다.
ConcurrentMessageListenerContainer는 어떻게 동작할까?
concurrency의 의미
ConcurrentMessageListenerContainer라는 이름을 처음 보면, 하나의 Consumer가 가져온 메시지를 여러 스레드에 나눠주는 구조를 떠올리기 쉽다. 특히 아래와 같이 concurrency를 설정하기 때문에 더욱 그렇게 느껴질 수 있다.
@KafkaListener(
    id = "orderListener",
    topics = ["orders"],
    groupId = "order-service",
    concurrency = "3"
)
fun consume(record: ConsumerRecord<String, String>) {
    orderService.process(record.value())
}
하지만 concurrency = 3은 하나의 Consumer가 가져온 메시지를 3개의 Worker Thread가 나누어 처리한다는 의미가 아니다.
Spring Kafka 공식 문서에 따르면 ConcurrentMessageListenerContainer의 concurrency를 3으로 설정하면 내부적으로 3개의 KafkaMessageListenerContainer가 만들어진다. 일반적인 토픽 구독 방식이라면 Kafka의 Consumer Group을 통해 각 Consumer에 파티션이 분배된다. 개념적으로는 다음과 같은 구조라고 볼 수 있다.
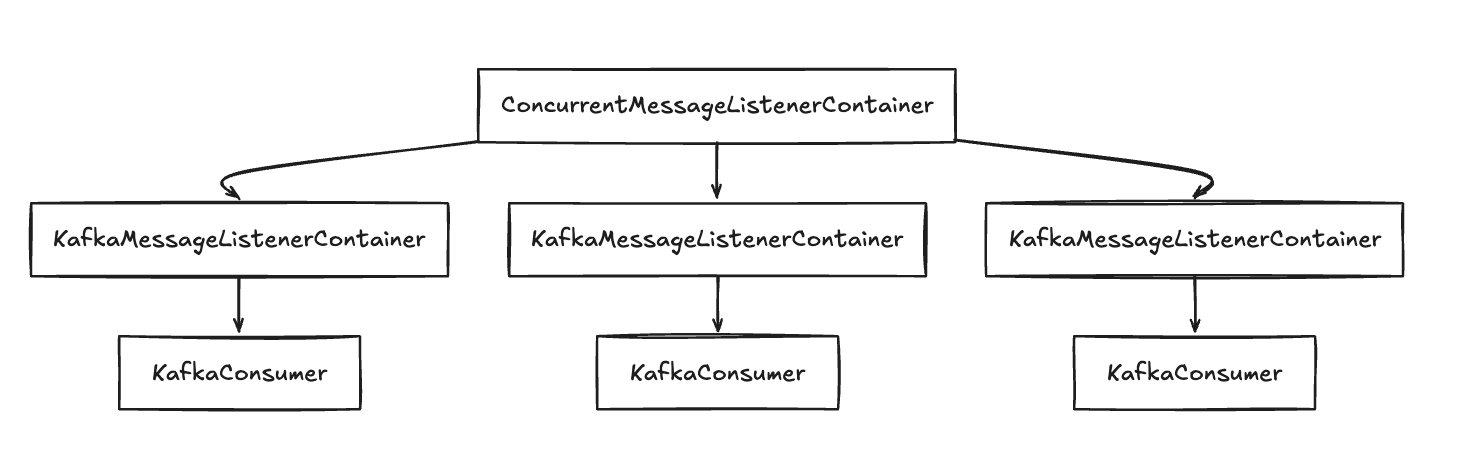
즉 concurrency = 3이면 일반적으로 각각 Consumer를 가진 자식 컨테이너 3개가 동작하게 된다.
부모 컨테이너와 자식 컨테이너
앞에서 살펴본 구조를 Spring Kafka 객체 기준으로 다시 보면 다음과 같다.
- ConcurrentMessageListenerContainer -> 부모 컨테이너
- KafkaMessageListenerContainer -> 자식 컨테이너
ConcurrentMessageListenerContainer는 설정된 concurrency에 따라 여러 개의 KafkaMessageListenerContainer를 생성하고 관리한다.
이때 말하는 부모와 자식은 Java의 상속 관계를 의미하지 않는다. 두 클래스 모두 AbstractMessageListenerContainer를 상속하는 별개의 객체이며, ConcurrentMessageListenerContainer가 여러 KafkaMessageListenerContainer를 내부적으로 관리하는 관계에 가깝다.
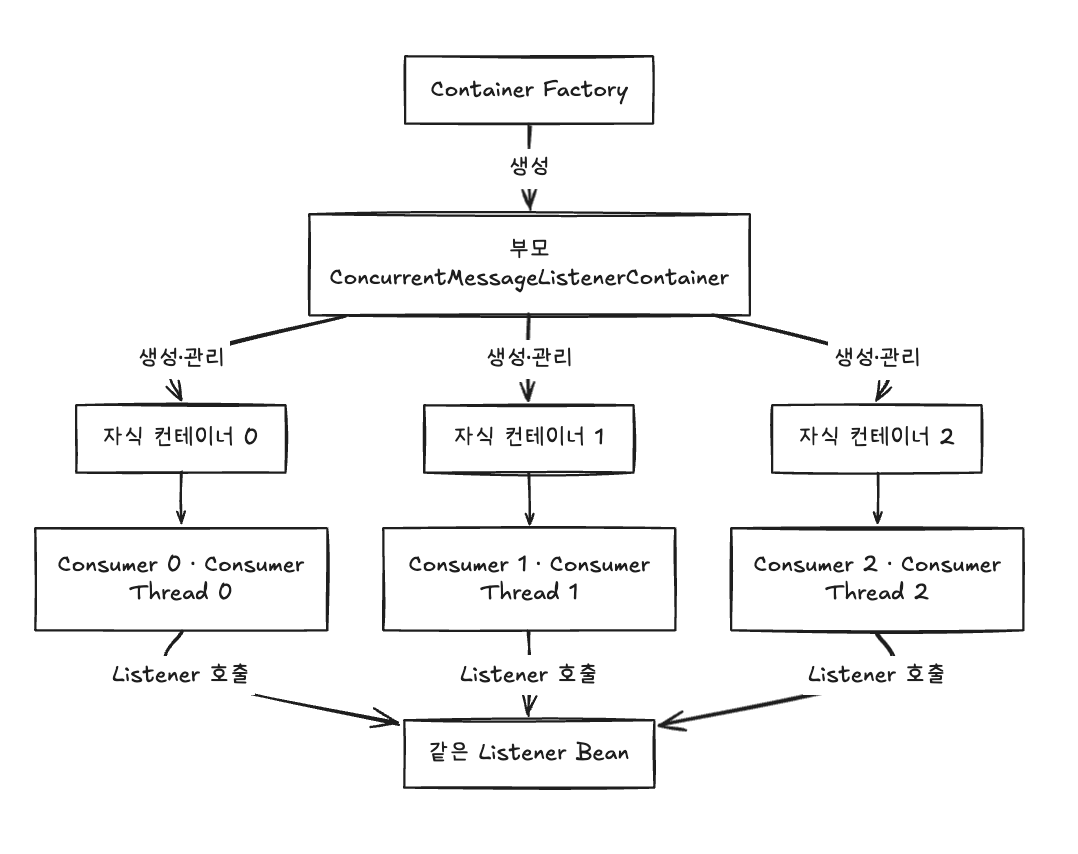
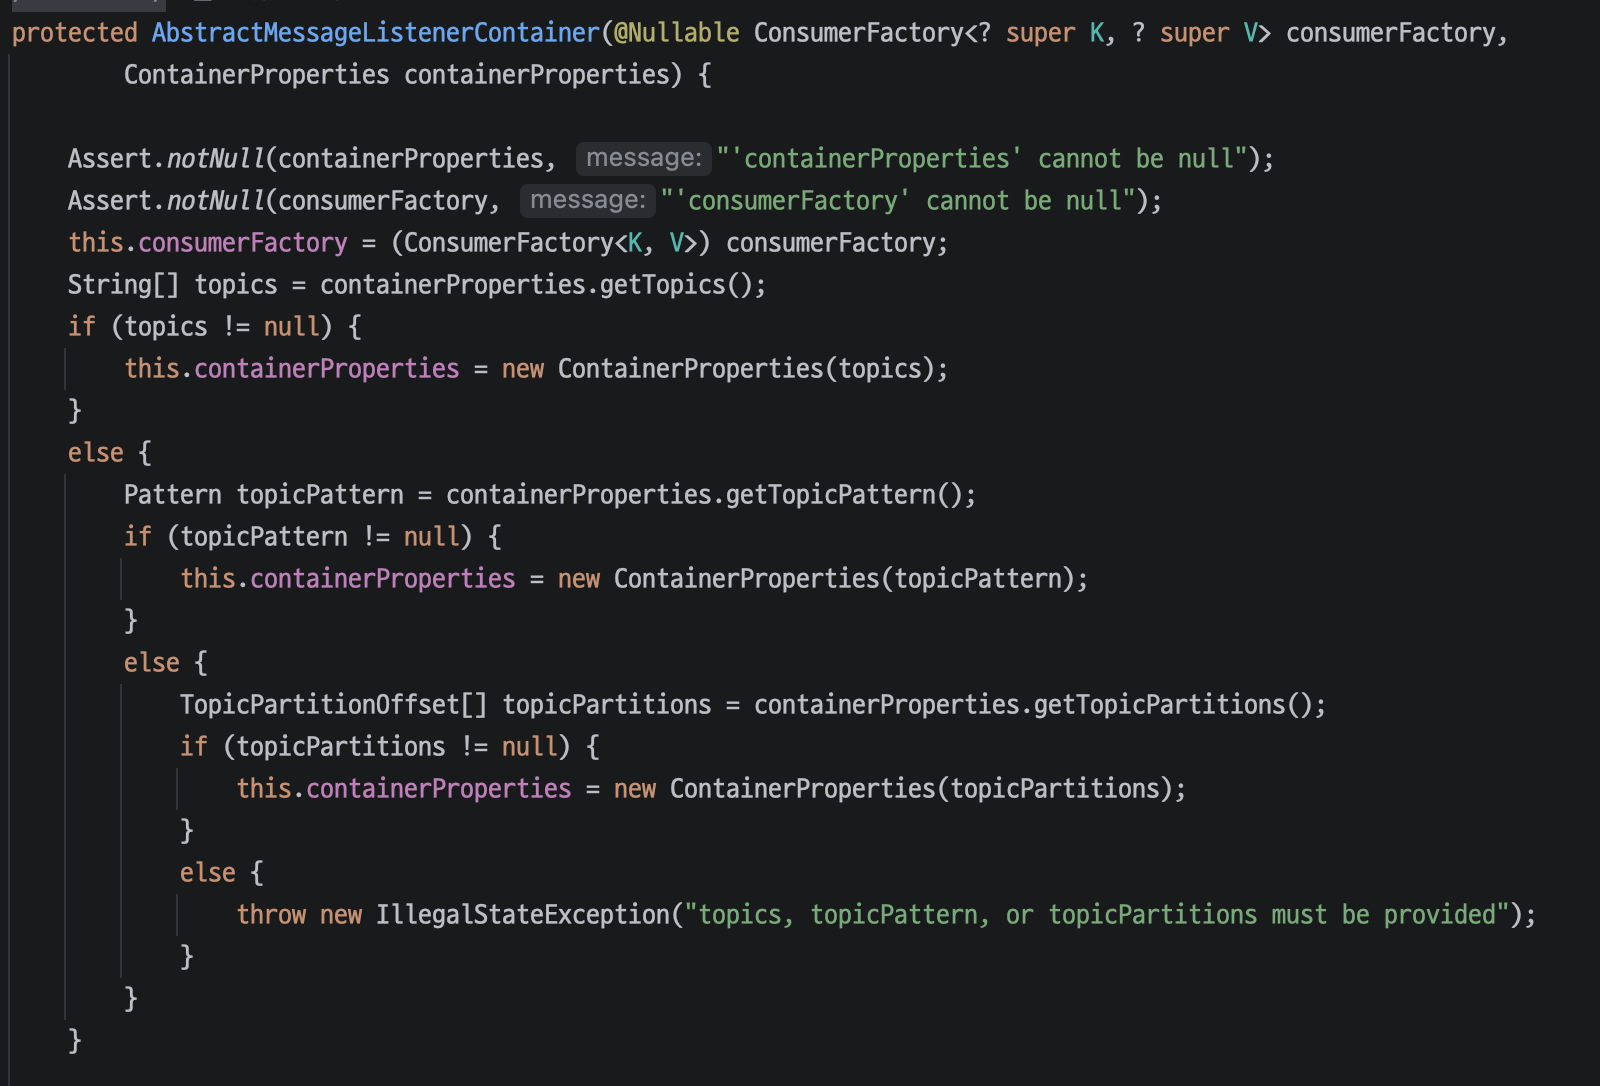
이 차이가 이번 버그의 핵심과 연결된다. 각 컨테이너가 서로 다른 객체이기 때문에, 상위 클래스에 정의된 인스턴스 필드 역시 각 객체가 독립적으로 가지고 있기 때문이다.
파티션 pause는 언제 적용될까?
Spring Kafka는 특정 파티션의 소비를 멈추거나 다시 시작할 수 있도록 다음 API를 제공한다.
- container.pausePartition(partition)
- container.resumePartition(partition)
여기서 pausePartition()을 호출했다고 해서 그 호출 시점에 곧바로 Kafka Consumer의 pause 처리가 끝난다고 생각하면 안 된다. Spring Kafka에서는 파티션의 pause와 resume이 Consumer의 poll()을 기준으로 적절한 시점에 적용된다. 공식 문서에서도 pausePartition()과 resumePartition()의 실제 적용과 요청 상태를 구분하고 있다.
그래서 다음 두 메서드도 역할이 다르다.
| 메서드 | 확인하는 내용 |
| isPartitionPauseRequested(tp) | 해당 파티션의 정지 요청이 등록되어 있는가 |
| isPartitionPaused(tp) | 해당 파티션이 실제로 정지 상태인가 |
예를 들어 pause 요청은 등록되었지만 아직 Consumer가 해당 요청을 적용하기 전이라면 다음과 같은 상태도 가능하다.
- isPartitionPauseRequested(tp) == true
- isPartitionPaused(tp) == false
즉, Spring Kafka는 pause 요청 상태와 실제 Consumer의 pause 상태를 별개의 개념으로 관리한다.
이번에 문제가 된 것은 바로 이 중 isPartitionPauseRequested()였다.
Spring Kafka 내부 코드 살펴보기
pause 요청은 어디에 저장될까?
이제 실제 Spring Kafka 코드를 따라가 보자. 부모인 ConcurrentMessageListenerContainer에 다음과 같이 요청했다고 가정한다.
parent.pausePartition(tp);부모 컨테이너는 해당 파티션을 담당하고 있는 자식 컨테이너를 찾은 뒤, 그 자식에게 pausePartition()을 호출한다.
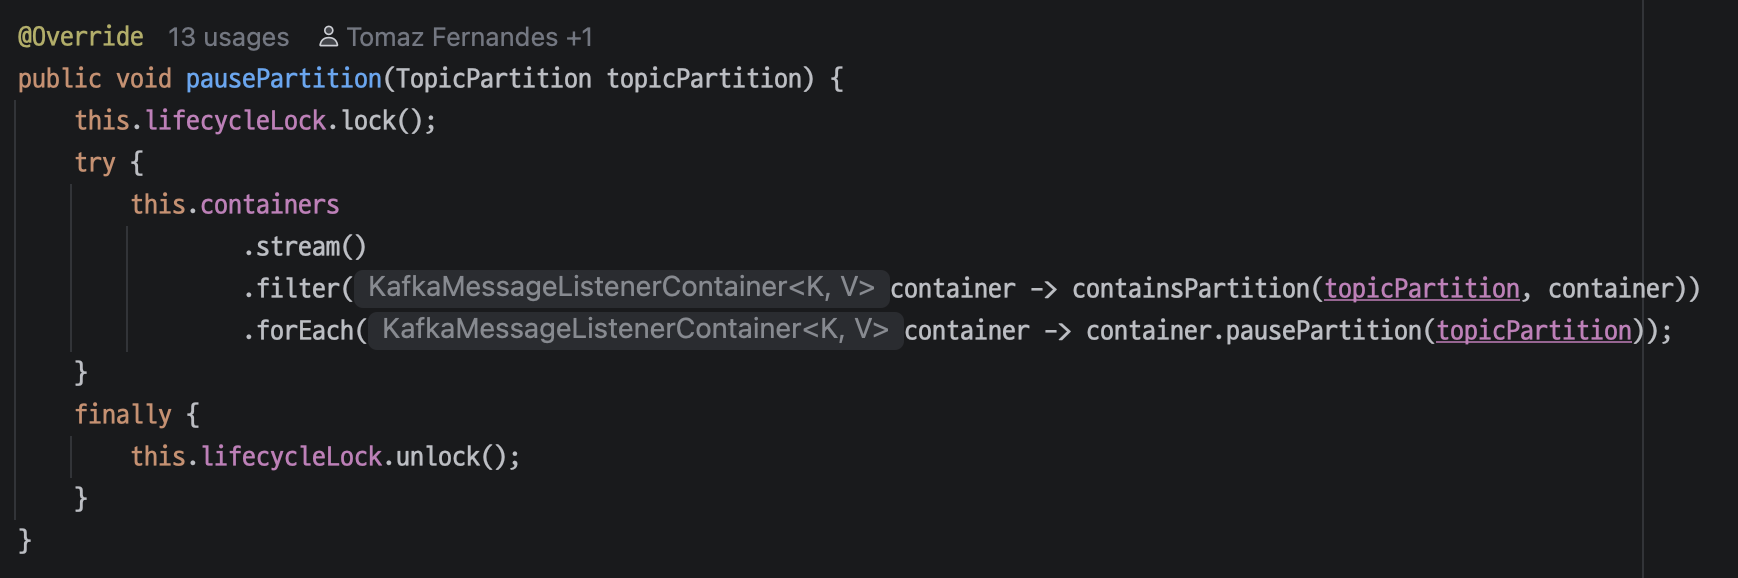
위 내부 구현 코드를 보면, 해당 파티션을 담당하는 자식 컨테이너를 필터링하고 각 컨테이너가 pausePartition을 호출하는 구조이다.
여기서 중요한 것은 pauseRequestedPartitions가 static 필드가 아닌 인스턴스 필드라는 점이다.
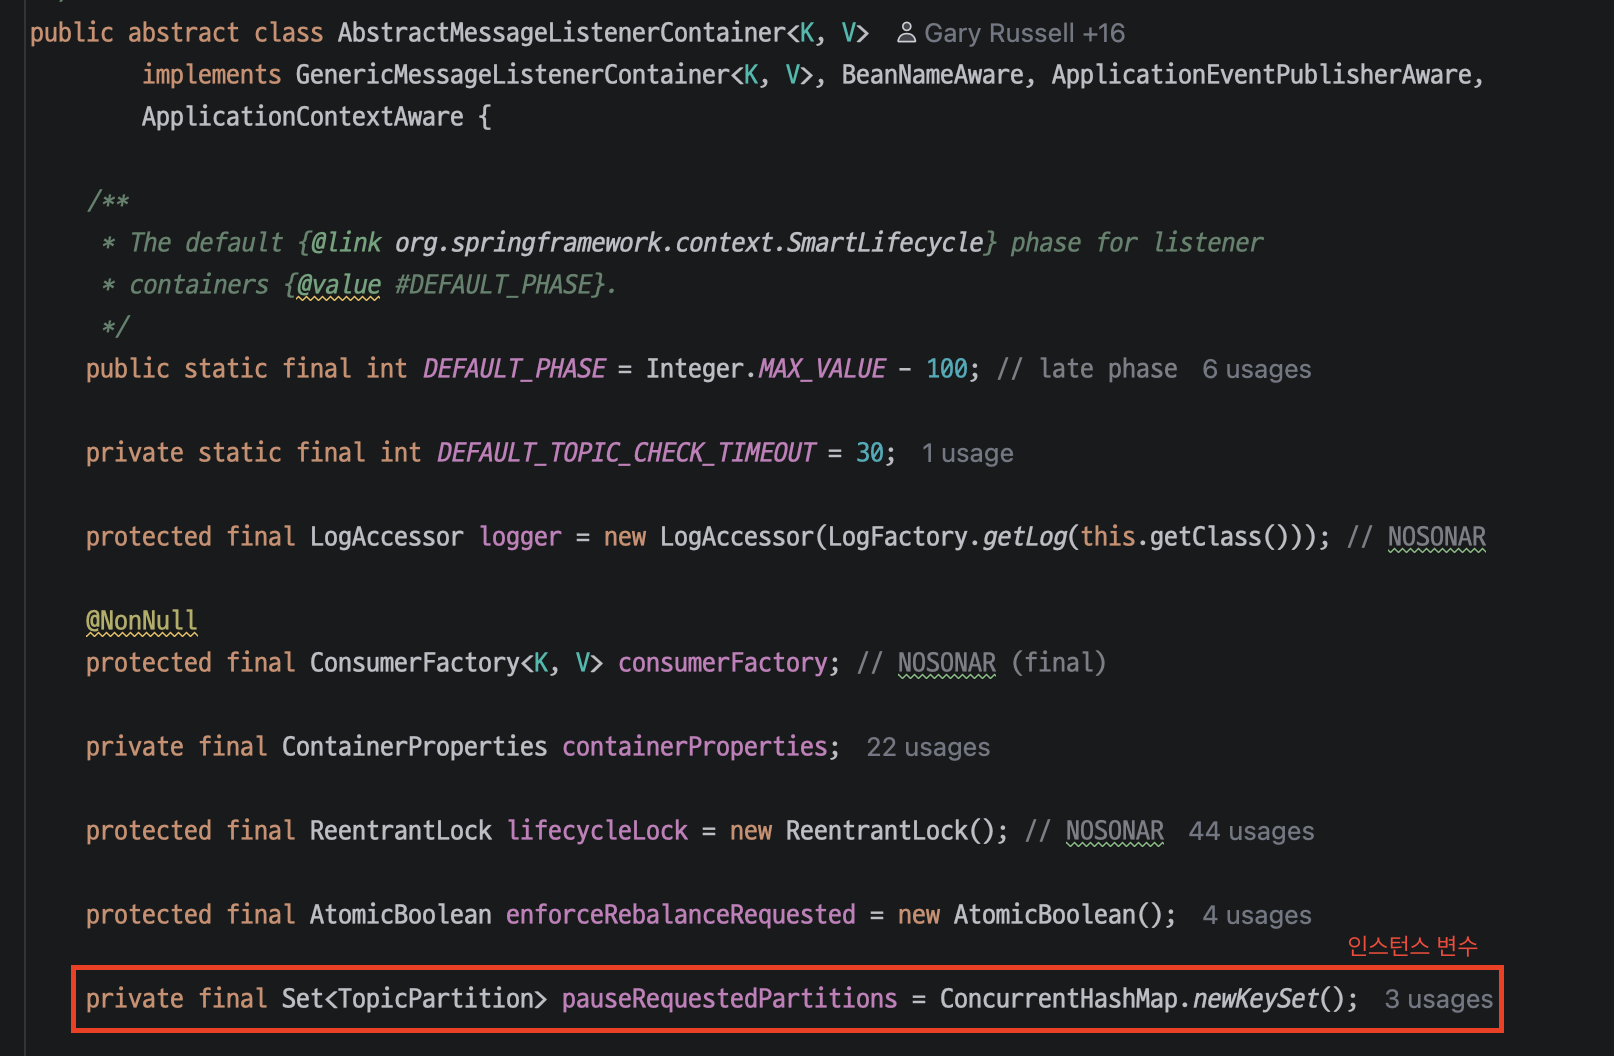
앞에서 이야기했듯 부모인 ConcurrentMessageListenerContainer와 각각의 자식 KafkaMessageListenerContainer는 서로 다른 인스턴스다. 따라서 각 객체는 별도의 pauseRequestedPartitions를 가지고 있다.
그리고 부모의 pausePartition()은 자신의 Set에 직접 요청을 저장하는 것이 아니라 해당 파티션을 담당하는 자식에게 요청을 위임한다.
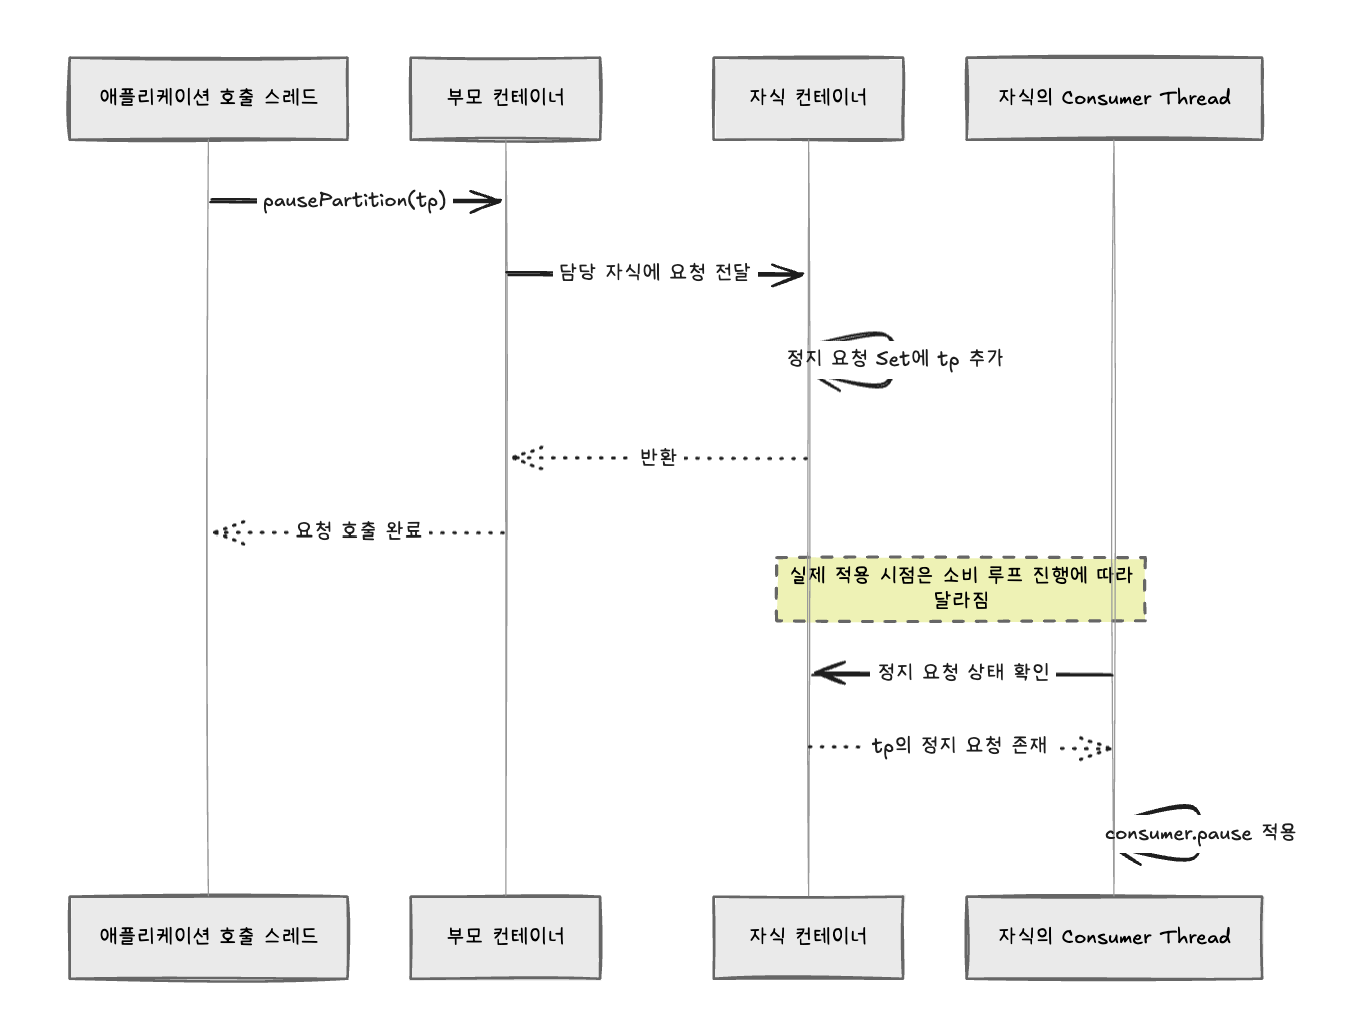
부모가 여러 자식을 관리하고 있으니, 실제 파티션을 담당하는 자식이 pause 요청을 관리하는 것도 자연스러운 구조다. 문제는 그 상태를 다시 조회할 때 발생했다.
isPartitionPauseRequested()는 어디를 보고 있었을까?
AbstractMessageListenerContainer의 isPartitionPauseRequested() 구현은 단순하다.
@Override
public boolean isPartitionPauseRequested(TopicPartition topicPartition) {
    return this.pauseRequestedPartitions.contains(topicPartition);
}
현재 객체의 pauseRequestedPartitions에 해당 파티션이 존재하는지 확인하는 것이다.
그런데 당시 Spring Kafka의 내부 코드에서 부모 컨테이너인 ConcurrentMessageListenerContainer는 이 메서드를 별도로 구현하지 않고 AbstractMessageListenerContainer의 구현을 그대로 상속받고 있었다. 따라서 다음과 같이 부모에서 호출하면, this는 부모 컨테이너가 된다.
하지만 앞에서 확인했듯 pause 요청은 부모가 아니라 자식의 Set에 저장되어 있다. 이러한 구조로 인해, 부모 컨테이너에서 isPartitionPauseRequested 메서드를 직접 호출하게 되면, 실제로 pause된 파티션이 존재하더라도 false를 반환하게 되는 것이다.
즉, 아래와 같은 불일치 상황이 발생하게 되는 것이다.
parent.pausePartition(tp)

child.isPartitionPauseRequested(tp)   // true
parent.isPartitionPauseRequested(tp)  // false
부모를 통해 pause를 요청했지만 실제 상태는 자식에게 저장되었고, 같은 부모를 통해 요청 여부를 조회하면 부모 자신의 비어 있는 Set을 확인하고 있었던 것이다.
이는 pause 요청을 저장한 객체와 pause 요청 여부를 조회한 객체가 달랐기 때문에 발생하는 이슈였다.
도출한 결론
resume은 실패한 것이 아니라, 호출 자체가 되지 않았다.
이제 처음 문제가 발생했던 애플리케이션 코드로 다시 돌아가 보자.
val pausedPartitions = candidates.filter {
    container.isPartitionPauseRequested(it)
}

pausedPartitions.forEach { partition ->
    container.resumePartition(partition)
}
여기서 container는 ConcurrentMessageListenerContainer, 즉 지금까지 부모라고 부르던 객체였다. 실제 pause 요청은 자식 컨테이너에 저장되어 있었지만, 위의 코드는 부모 자신의 상태를 확인하는 코드가 된 것이다.
따라서 실제로 pause 요청이 존재하는 파티션이 있음에도 pausedPartitions가 emptyList로 반환이 된 것이었다. 때문에 그 아래 코드는 실행할 대상 자체가 없어졌다.
처음에는 resumePartition()이 제대로 동작하지 않는다고 생각했지만, 실제 원인은 달랐다. resume이 실패한 것이 아니라, resume이 호출되기 전에 대상 파티션이 모두 필터링되고 있었던 것이다.
재미있는 점은 부모의 resumePartition() 내부에서는 이미 자식 컨테이너의 pause 요청 상태를 확인하고 있었다는 것이다.
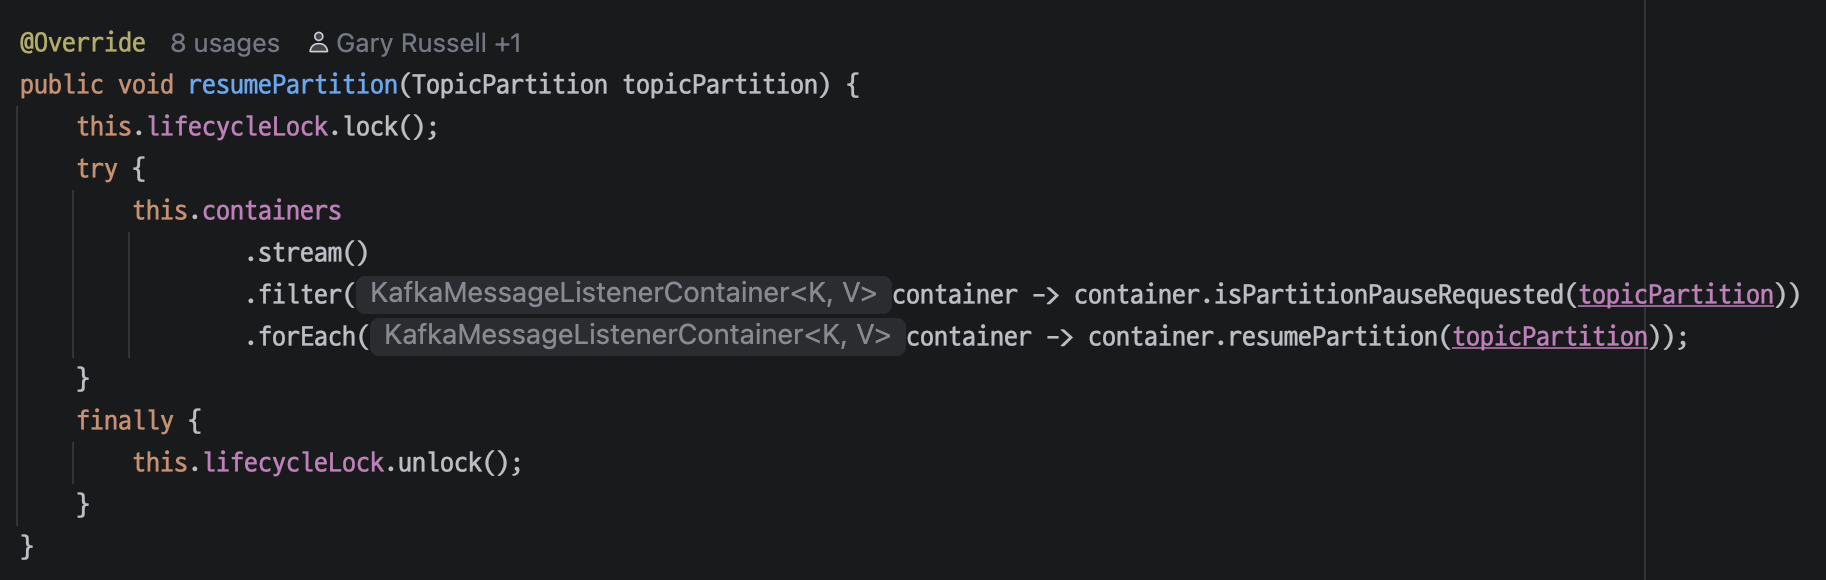
즉 내부적으로는 자식이 상태의 기준이라는 사실을 알고 있었다.
또 실제 pause 여부를 조회하는 isPartitionPaused() 역시 ConcurrentMessageListenerContainer에서 자식들의 상태를 확인하도록 구현되어 있었다.
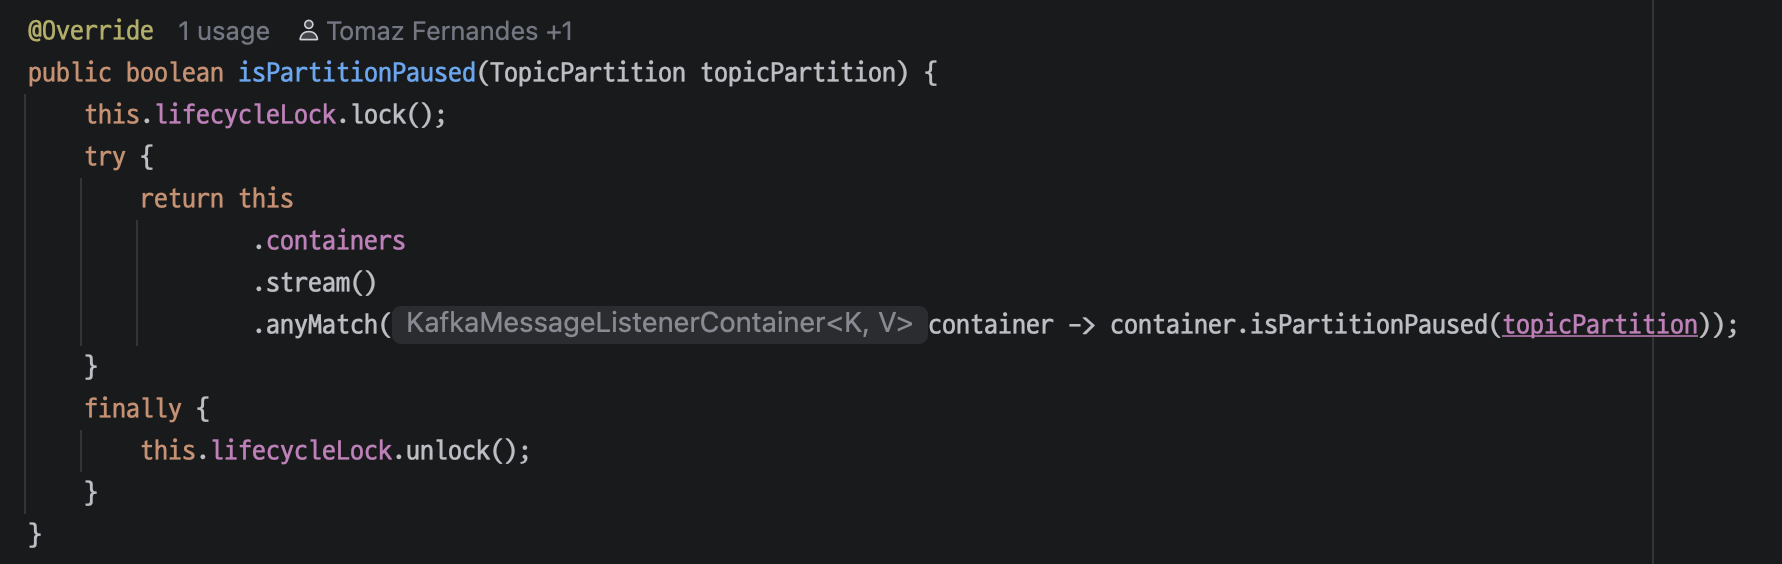
그런데 왜 하필 isPartitionPauseRequested()만 부모 클래스의 기본 구현을 그대로 사용하고 있는지 의아했다.
Spring Kafka 코드를 수정하다
버그라고 판단한 이유
1. 공식 문서에서의 isPartitionPauseRequested() 정의
Spring Kafka 공식 문서는 isPartitionPauseRequested()를 단순히 해당 파티션에 pause가 요청되었는지 확인하는 메서드로 설명하고 있다. 때문에 공개 API만 보고 구현을 했다면 다음과 같은 코드는 매우 자연스러운 코드라고 판단했다.
if (container.isPartitionPauseRequested(topicPartition)) {
    container.resumePartition(topicPartition);
}
호출하는 입장에서는 container가 내부적으로 부모와 자식으로 나뉘어 있고, pause 요청이 어느 객체의 Set에 저장되는지까지 알고 있어야 할 이유가 없다.
2. isPartitionPaused()와의 비대칭
또한, 실제 pause 여부를 확인하는 isPartitionPaused()와의 비대칭이다. 실제로 isPartitionPaused() 메서드는 부모 컨테이너 클래스에 이미 오버라이드되어 자식 컨테이너들을 확인하는 방식으로 동작한다. 따라서 기존 구현에서는 부모 컨테이너가 실제로 pause된 상태라고 하면서(isPartitionPaused) 정작 pause 요청은 없다고 반환하는(isPartitionPauseRequested) 기묘한 상황이 발생할 수 있다.
일반적으로 pause 요청이 먼저 발생하고, 그 요청이 적용되어 실제 pause 상태가 되는 흐름이기 때문에 위 반환값만을 보았을 땐, 두 API의 의미가 서로 맞지 않아 보인다.
3. ConcurrentMessageListenerContainer의 역할
이 외에 puasePartition(), resumePartition()과 같은 메서드들 모두 부모 컨테이너에서 자식 컨테이너들을 확인하는 방식으로 메서드가 이미 오버라이드 되어있다. 즉, 모두 부모인 ConcurrentMessageListenerContainer가 자식들을 감싸는 추상화처럼 동작한다.
그런데 isPartitionPauseRequested() 메서드만 부모 컨테이너 클래스에서 오버라이드가 누락되어 있으며 부모와 자식의 내부 상태 차이를 그대로 노출하고 있는 점은 충분히 이상하다고 느낄 지점이었다.
이러한 이유들로 "isPartitionPauseRequested() 역시 자식 컨테이너들의 상태를 반영하는 것이 일관된 동작 아닐까?" 라는 생각으로 Spring Kafka에 Issue를 등록했다.
첫 오픈소스 기여 도전이기도 했고, 내가 분석한 내용이 정말 맞는지 스스로도 확신이 부족했다. 그래서 설득하기 위해 나는 해당 코드를 왜 이상하다고 판단했는지, 내부 코드가 어떻게 동작하는지, 부모와 자식에서 각각 어떤 값이 반환되는지까지 꽤 자세하게 적었다. 나중에 다른 Issue들을 보고 나니 '내가 너무 구구절절 적었나...?' 싶기도 했다ㅋㅋ
그래도 결과적으로 Issue에는 type: bug 라벨이 붙었고, 문제로 받아들여졌다.
어떻게 수정했을까?
수정 전 ConcurrentMessageListenerContainer는 isPartitionPauseRequested()를 별도로 구현하지 않고, 부모 클래스인 AbstractMessageListenerContainer의 구현을 그대로 사용하고 있었다.
때문에 수정 방향은 비교적 단순했다. ConcurrentMessageListenerContainer에서 isPartitionPauseRequested()를 오버라이드하고, 자식 컨테이너들의 요청 상태를 확인하도록 변경하는 것이다.
@Override
public boolean isPartitionPauseRequested(TopicPartition topicPartition) {
    this.lifecycleLock.lock();
    try {
        return this.containers.stream()
                .anyMatch(container -> container.isPartitionPauseRequested(topicPartition));
    } finally {
        this.lifecycleLock.unlock();
    }
}
이제 자식 컨테이너 중 하나라도 해당 파티션에 pause 요청을 가지고 있다면 부모에서도 true를 반환한다. 수정 후에는 처음 기대했던 동작이 가능해진다.
parent.pausePartition(tp);

parent.isPartitionPauseRequested(tp); // true

parent.resumePartition(tp);

parent.isPartitionPauseRequested(tp); // false
수정된 코드는 몇 줄에 불과했지만, 어떤 방식으로 자식의 상태를 조회할지는 한 번 더 고민해 볼 필요가 있었다.
구현
실제 pause 상태를 조회하는 isPartitionPaused()는 이미 ConcurrentMessageListenerContainer에서 오버라이드되어 있었고, 모든 자식 컨테이너를 확인하는 방식으로 동작하고 있었다.
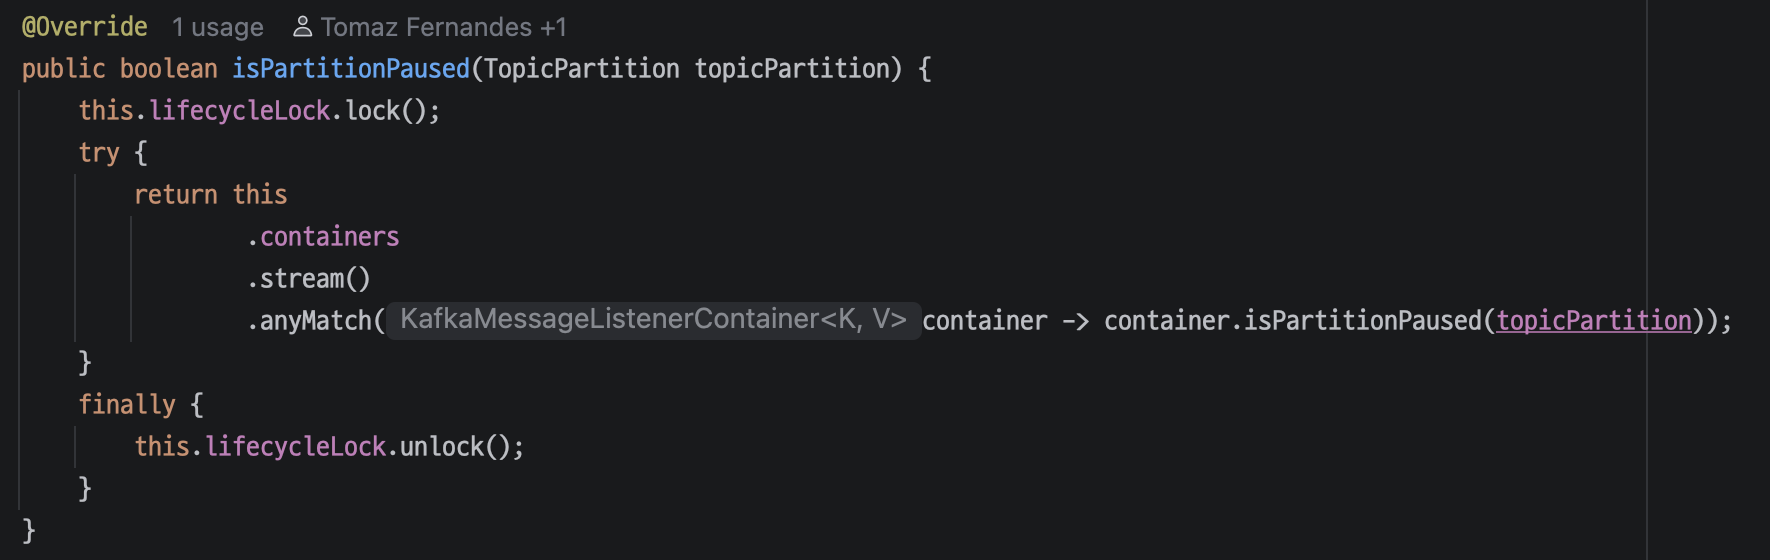
때문에 같은 ConcurrentMessageListenerContainer에서 제공하는 두 상태 조회 API(isPartitionPauseRequested(), isPartitionPaused()라면 isPartitionPauseRequested() 역시 isPartitionPaused()와 동일한 방식으로 동작하도록 맞추는 것이 자연스럽다고 생각했다. 그래서 새롭게 isPartitionPauseRequested()를 오버라이드해야 하는 상황에서, 일관성을 맞추기 위해 기존에 존재하던 isPartitionPaused()의 구현 패턴을 그대로 따랐다.
결국 이번 수정의 핵심은 단순했다. ConcurrentMessageListenerContainer가 관리하는 실제 상태는 자식 컨테이너에 있으니, 부모에서 상태를 조회할 때도 자식들의 상태를 반영하도록 만든 것이다.
그리고 첫 PR이 반영되었다
Issue를 등록한 뒤 수정 코드와 테스트를 작성해 PR을 올렸다. 그리고 생각보다 정말 빠르게 답변이 왔다. (하루도 걸리지 않았다.)
최종적으로는 메인테이너가 내가 작성한 코드를 조금 다듬은 뒤 프로젝트에 반영되었다.
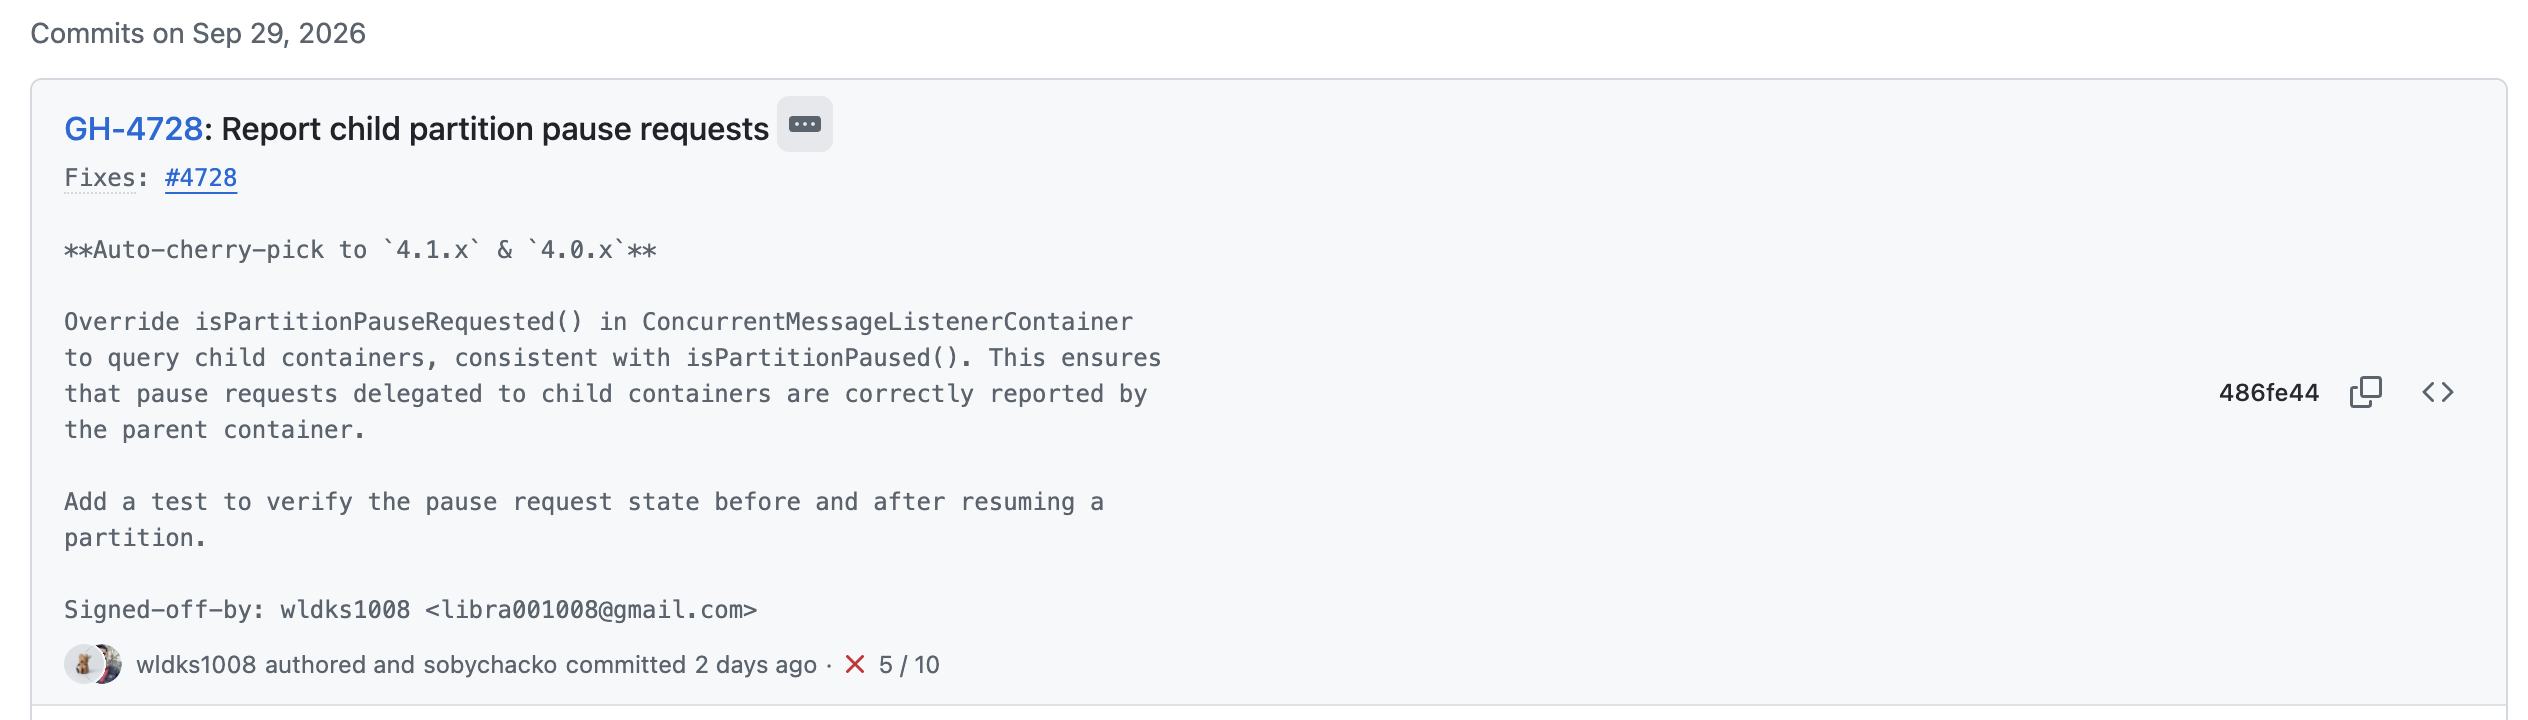
평소에는 라이브러리 소스를 문제가 생겼을 때 읽어보기만 했는데, 내가 작성한 변경을 기반으로 실제 Spring Kafka의 코드가 수정되었다는 것이 신기했다. 최종 코드에서는 일부 표현이 정리되었고, 수정한 클래스와 테스트의 @author 목록에도 내 이름이 추가되었다.
늘 가져다 사용하기만 하던 오픈소스의 소스 코드 안에 내 이름이 들어 있는 것을 보니 그제야 조금 실감이 났다.
물론 첫 기여답게(?) 놓친 것도 있었다.
Spring 프로젝트에서는 DCO의 Signed-off-by에 실명을 사용해야 하는데 GitHub 닉네임을 넣어서, 메인테이너에게 실명을 사용해 달라는 이야기도 들었다. 다음에는 안 까먹을 것 같다.ㅋㅋ
마무리
사실 회사에 입사한 뒤 Kafka를 처음으로 다뤄보았기 때문에, 경험도 아직 부족하고 스스로 공부할게 많다고 느껴왔었다. 때문에 문제의 원인을 찾은 이후에도 정말 라이브러리의 버그일지에 대한 확신이 없었다.
"내가 코드를 잘못 이해한 건 아닐까?", "원래 이렇게 동작하도록 만들어진 것은 아닐까?", "Spring Kafka처럼 전 세계에서 널리 사용하는 프로젝트에서, 그것도 이런 기본적인 API 동작에서 내가 정말 버그를 발견한 게 맞나?" 그런 생각이 계속 들었다.
그런데 이번 일을 겪고 나니 오픈소스 기여가 꼭 거창한 것에서 시작하는 것은 아니라는 생각이 들었다.
운영 중 이상한 현상을 하나 발견했고,왜 그런지 궁금해서 애플리케이션 코드를 따라갔고, 그래도 설명되지 않아서 라이브러리 내부 구현까지 들어갔고, 서로 맞지 않는 동작을 발견해서 Issue를 작성했고, 그 문제를 해결할 코드를 만들어 PR을 올렸다.
돌이켜보면 그 과정이 전부였다.
이번 경험에서 가장 재미있었던 점은 내가 겪은 문제를 해결하기 위해 작성한 몇 줄의 코드가 같은 라이브러리를 사용하는 다른 사람이 겪을 지도 모르는 문제를 해결해줄 수 있다는 것이었다.
운영하면서 마주친 작은 이상함을 그냥 넘기지 않고 끝까지 따라가 본 결과가 첫 오픈소스 기여로 이어졌다. 생각했던 것보다 훨씬 뿌듯한 경험이었다. 다음에도 이상한 동작을 발견한다면, 이번에는 스스로의 판단에 대해 조금 덜 의심하면서 소스 코드를 열어볼 수 있을 것 같다. 😎
- Spring Kafka: Message Listener Containers
- Spring Kafka: Pausing and Resuming Partitions
- 수정 전 4.1.1 ConcurrentMessageListenerContainer
- 수정 전 4.1.1 AbstractMessageListenerContainer
- Issue #4728
- PR #4729
- main 반영 커밋
'System Architecture > Kafka' 카테고리의 다른 글
| 놓치기 쉬운 Consumer Offset 설정 (0) | 2026.09.01 |
|---|