들어가며
최근에, Kafka Cluster를 신규 Cluster로 이관해야 하는 상황이 생겼다. 단순히 Producer와 Consumer가 바라보는 bootstrap server만 변경하면 될 것 같지만, 실제 운영 중인 Topic을 이관할 때는 특히 고려해야 할 부분이 하나 더 있다. 바로 Consumer Offset이다.
Kafka Cluster 이관
작업 단계
기존 Kafka Cluster를 A, 새롭게 이관할 Kafka Cluster를 B라고 해보자. 이관 과정에서 Producer와 Consumer를 동시에 변경할 수도 있겠지만, 배포 시점에 따라 기존 Cluster에 아직 소비되지 않은 메시지가 남아 있을 수 있다.
때문에 작업 시, 메세지 유실을 최대한 방지하고자 Producer를 먼저 신규 Cluster로 전환하고 기존 Consumer가 기존 클러스터에 위치한 토픽의 메시지를 모두 소비한 이후 Consumer를 신규 Cluster로 전환하고자 하였다.
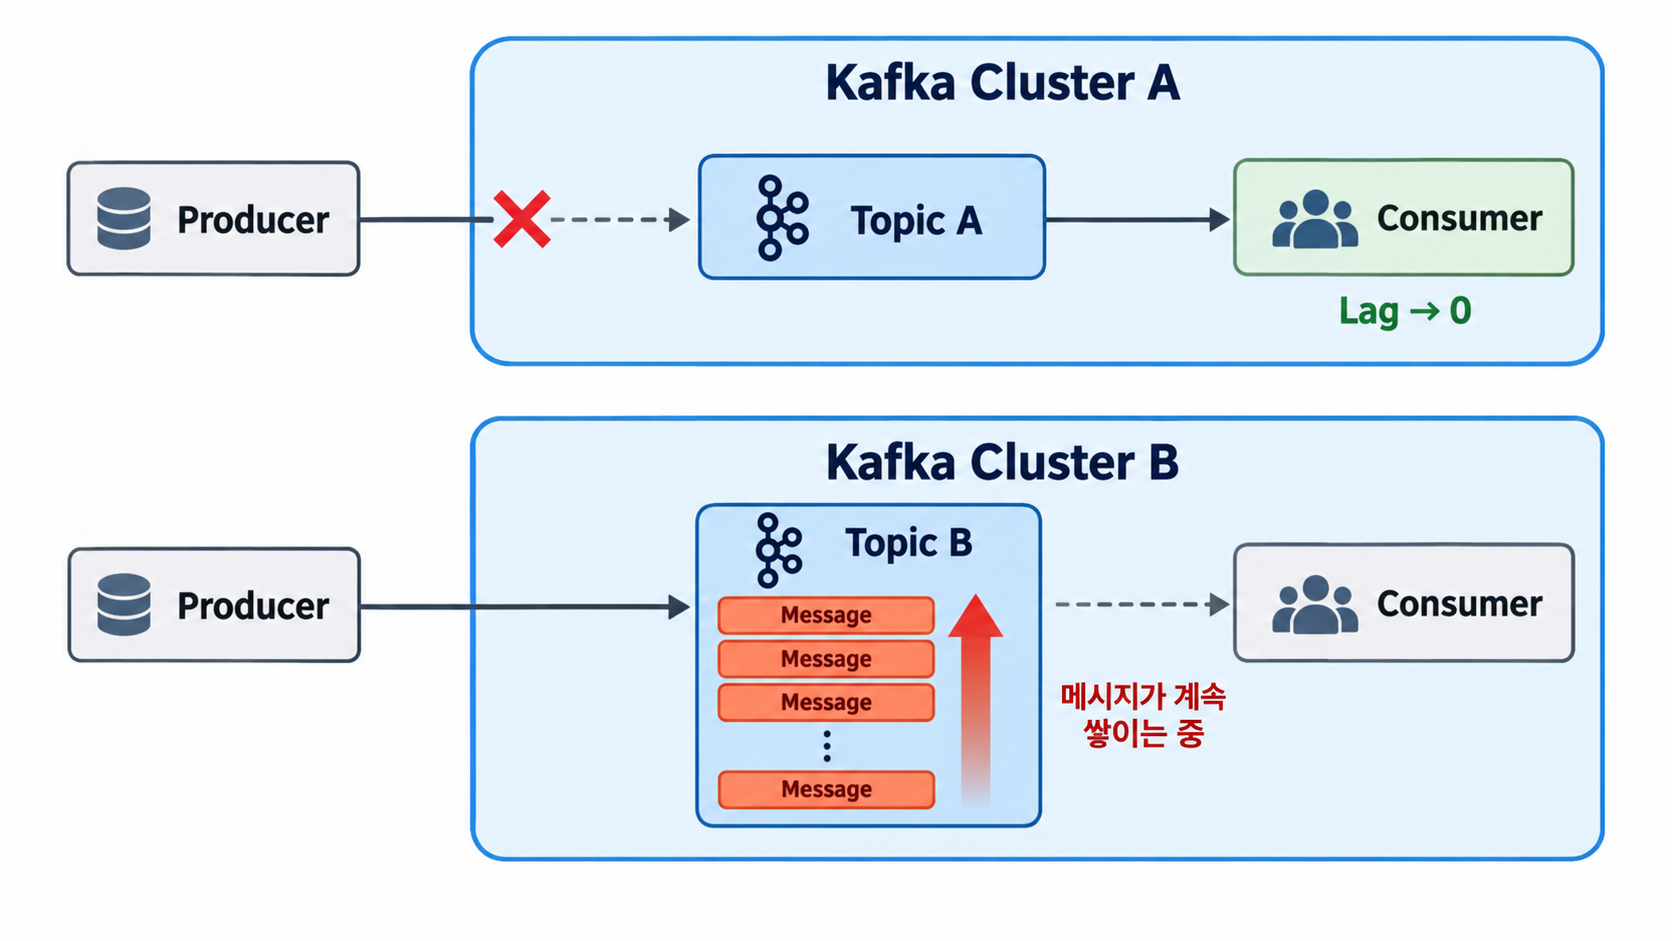
Producer부터 먼저 신규 Cluster로 변경했기 때문에 기존 Consumer가 Cluster A의 메시지를 처리하는 동안 Cluster B의 Topic에는 새로운 메시지가 계속 쌓이게 된다. 편의상 Lag이 쌓인다고 표현할 수 있지만, 엄밀하게 말하면 Consumer Group의 committed offset이 아직 존재하지 않는다면 Kafka에서 계산하는 Consumer Lag이라기보다는 아직 소비되지 않은 backlog가 쌓이고 있는 상태에 가깝다. 어쨌든 중요한 것은 Consumer를 신규 Cluster로 전환할 때 이미 Topic 안에 처리해야 할 메시지가 존재한다는 점이다. 그런데 여기서 문제가 하나 생긴다.
주의점
auto.offset.reset
Kafka Consumer에는 auto.offset.reset이라는 옵션이 존재한다. 해당 속성은 컨슈머가 이전에 오프셋을 커밋한 적이 없거나, 커밋된 오프셋이 유효하지 않을 때(대개 컨슈머가 오랫동안 읽은 적이 없어서 오프셋의 레코드가 이미 브로커에서 삭제된 경우), 파티션을 읽기 시작할 때의 작동을 정의힌다. 만약 auto.offset.reset을 none으로 설정된 상태에서 유효하지 않은 오프셋부터 읽으려 할 경우 예외가 발생한다.
일반적으로 earliest, latest 이 두 가지 옵션을 많이 사용하여 기본값은 latest이다.
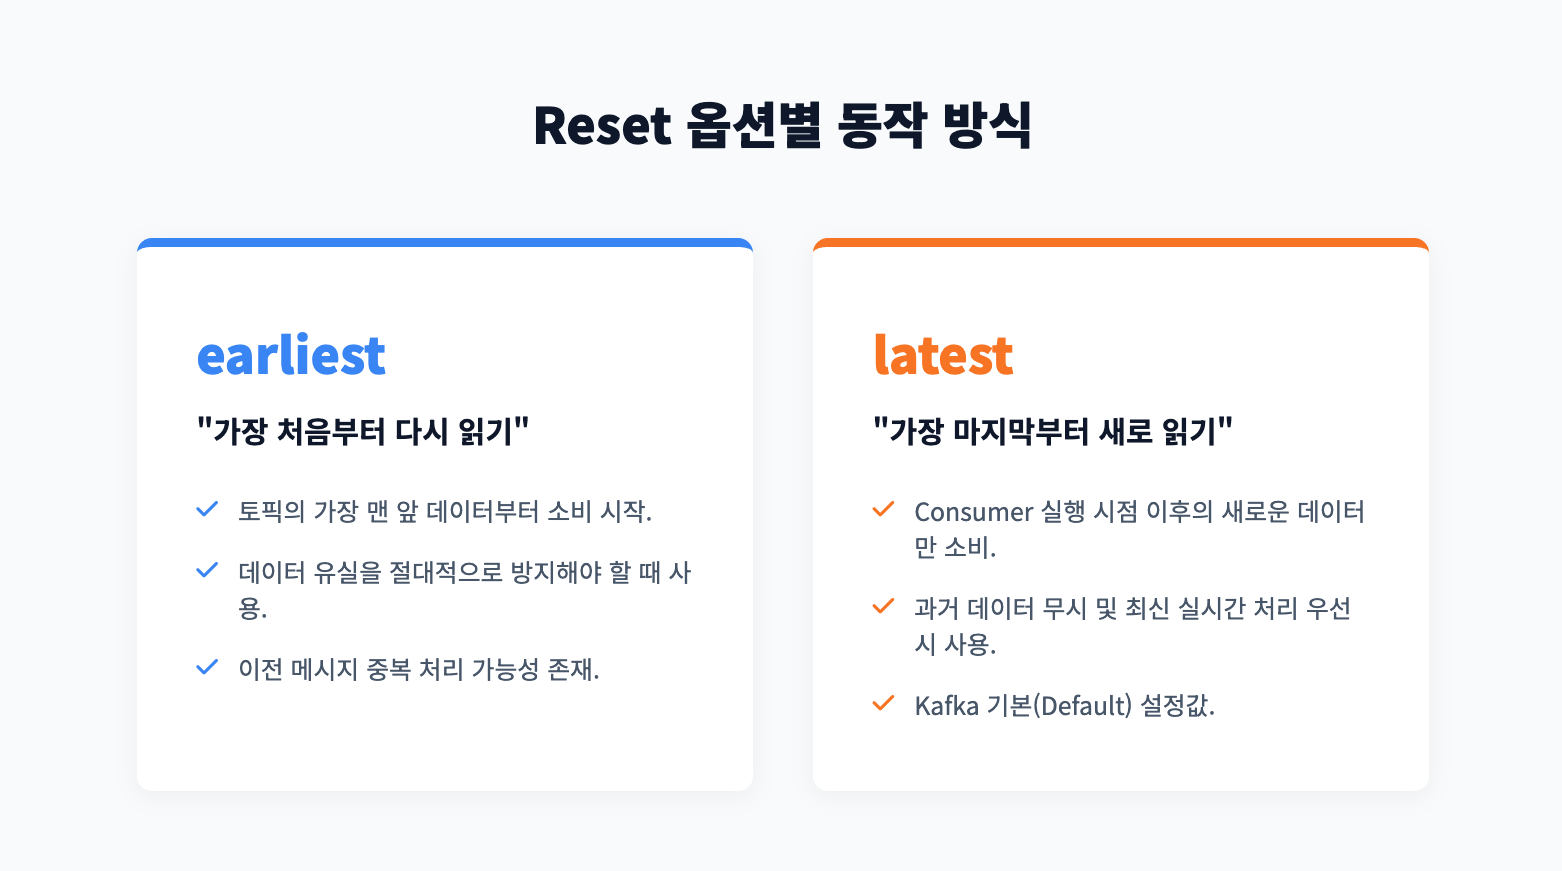
earliest 설정은 유효한 오프셋이 없을 경우 파티션의 맨 처음부터 모든 데이터를 읽는 방식이다. 반대로 latest의 경우, 가장 최신의 레코드(즉, 컨슈머가 작동하기 시작한 다음부터 쓰여진 레코드)부터 읽기 시작한다.
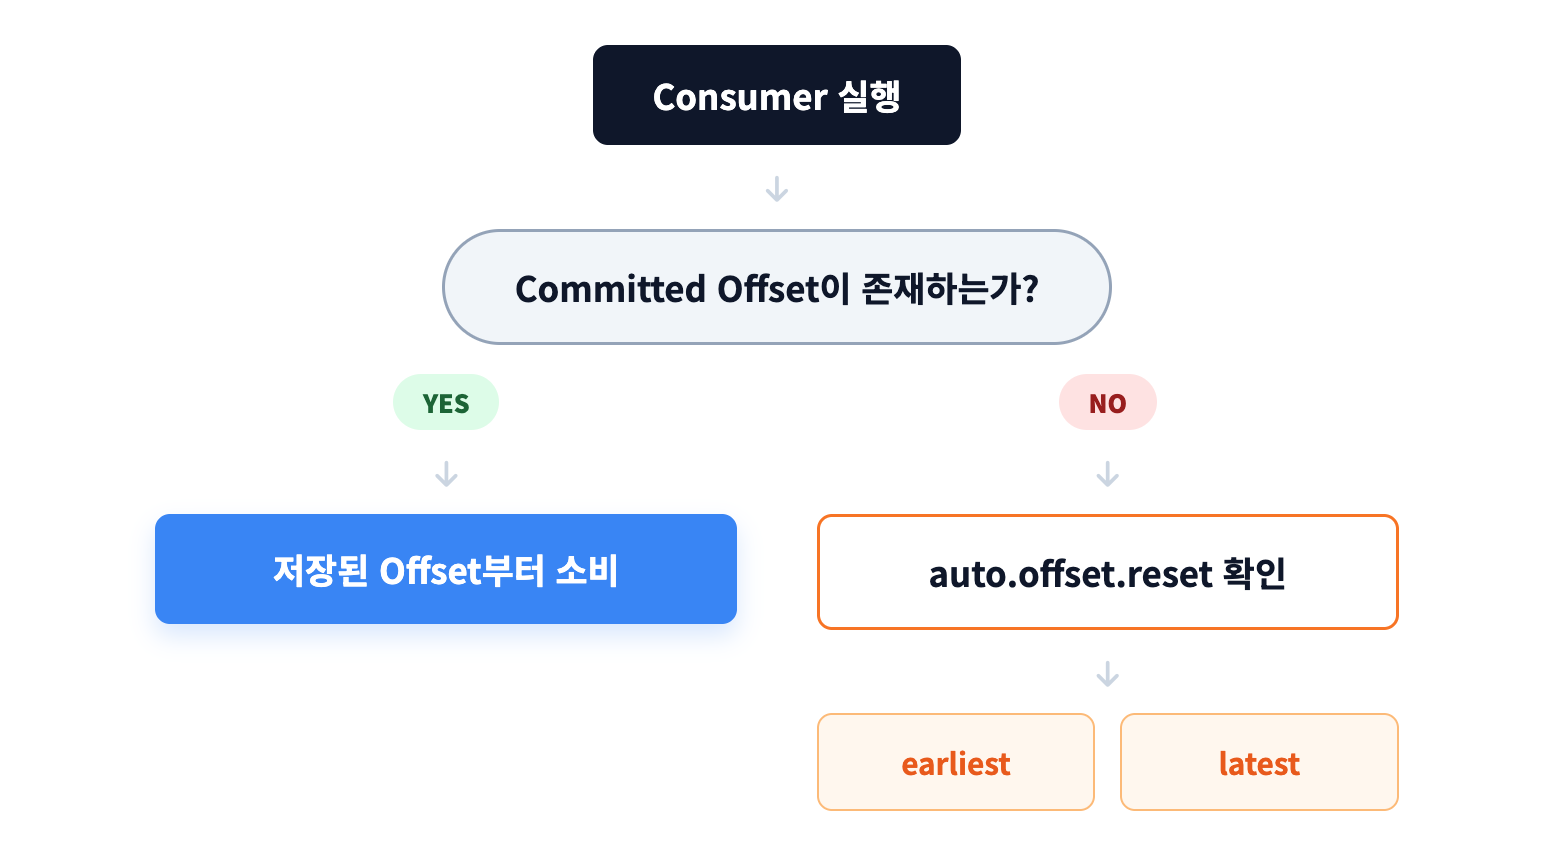
즉 정리하면, 먼저 Consumer Group에 저장되어 있는 committed offset을 확인하고 해당 Offset이 존재하지 않을 때 auto.offset.reset이 사용된다.
신규 Cluster에는 유효한 Offset이 없다
기존 Cluster A에서 Consumer가 아무리 열심히 메시지를 소비하고 Offset을 Commit하고 있었다고 하더라도 해당 정보는 Cluster A에 존재한다. Cluster B는 완전히 새로운 Kafka Cluster이기 때문에 같은 group.id를 사용하더라도 기존 Cluster에서 사용하던 committed offset이 자동으로 넘어오지는 않는다. 따라서 Consumer가 Cluster B에 처음 붙는 상황에서는 committed offset이 존재하지 않는 상황인 것이다.
latest로 실행하면?
Consumer 설정의 auto.offset.reset 설정이 latest 라고 가정해보자. Consumer Group에 committed offset이 존재하지 않기 때문에 auto.offset.reset이 동작한다. 그리고 설정이 latest이기 때문에 현재 Topic의 마지막 위치부터 Consumer가 데이터를 읽기 시작한다.
0    1    2    3    4    5    ...    1000
●────●────●────●────●────●────────────●
                                      ↑
                                 Consumer 시작
그러면 Producer를 먼저 Cluster B로 옮긴 이후 0 ~ 999까지 쌓여있던 메시지는 Consumer 입장에서 읽지 않고 넘어가게 된다.
Kafka에 실제 데이터가 삭제되는 것은 아니지만, 서비스에서 해당 메시지를 처리하지 못한다는 점에서는 사실상 메시지 유실과 동일한 문제가 발생한다.
earliest로 실행하면?
신규 Cluster에 committed offset이 없으므로 earliest가 적용되고 Topic에 존재하는 가장 오래된 메시지부터 데이터를 읽게 된다.
0    1    2    3    4    5    ...    1000
●────●────●────●────●────●────────────●
↑
Consumer 시작
이렇게 하면 Producer가 미리 Cluster B로 보내놓은 메시지를 건너뛰지 않고 모두 처리할 수 있다.
여기서 한 가지 헷갈릴 수 있는데, auto.offset.reset=earliest라고 해서 Consumer가 실행될 때마다 항상 Topic의 처음부터 읽는 것은 아니다. Consumer가 메시지를 처리하고 Offset을 Commit했다면 이후부터는 committed offset이 존재하기 때문에 auto.offset.reset 자체가 동작하지 않는다. 예를 들어 Consumer가 Offset 500까지 처리했다고 해보자.
0 ───────────────── 500 ─────────────── 1000
                     ↑
                Committed Offset
Consumer가 재시작하더라도 earliest인 0에서 시작하는 것이 아니라 committed offset인 500부터 이어서 데이터를 처리한다.
신규 Cluster에 유효한 Offset을 미리 만들면?
앞에서 살펴봤듯이 auto.offset.reset은 committed offset이 없을 때 동작한다. 그렇다면 Consumer를 배포하기 전에 committed offset을 미리 만들어놓으면 어떻게 될까? 신규 Cluster의 Consumer Group Offset을 Topic의 earliest 위치로 미리 설정한 뒤 Consumer는 기존 설정인 latest 상태 그대로 실행하는 것이다.
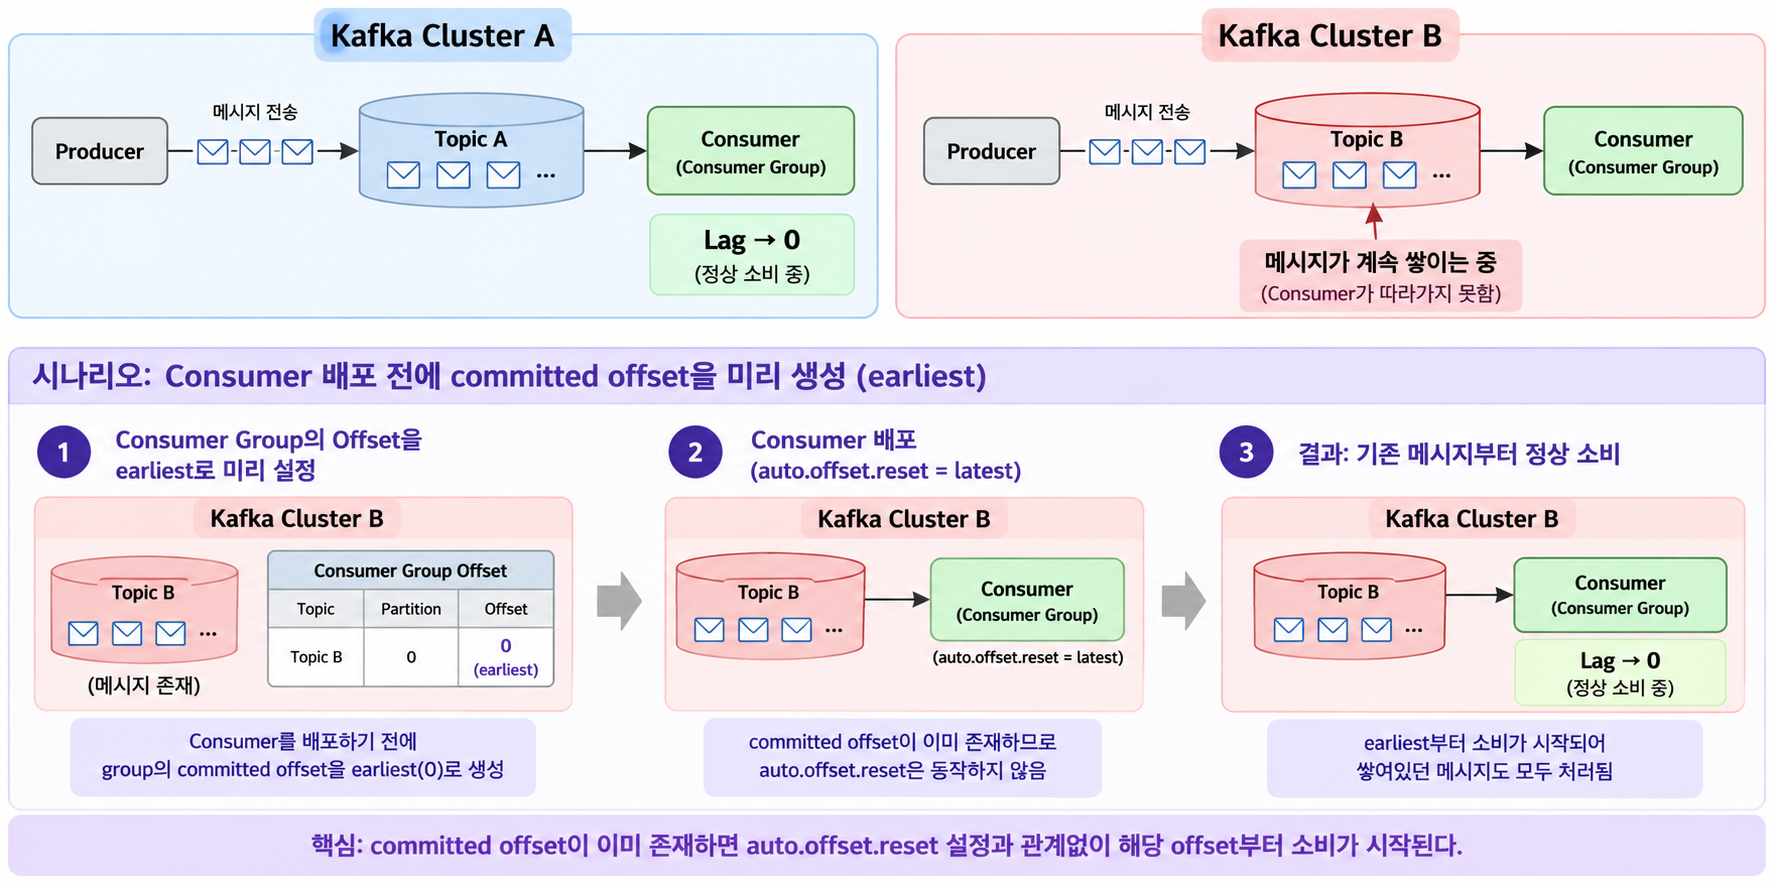
Consumer 설정은 분명 latest인데 어떻게 0부터 데이터를 읽을 수 있을까? 앞서 설명한 Consumer의 동작 순서를 다시 보면 이해하기 쉽다. 정답은, auto.offset.reset=latest라는 설정은 존재하지만 Consumer Group의 committed offset이 이미 존재하기 때문에 해당 옵션 자체가 사용되지 않는다. 결국 미리 설정한 earliest offset부터 메시지를 읽게 된다.
Retention 정책과 Offset
여기서 earliest라는 이름 때문에 Offset 0을 의미한다고 생각할 수도 있다. 하지만 earliest는 말 그대로 현재 Topic에 남아 있는 가장 오래된 Offset이다. Kafka의 retention에 의해 이전 데이터가 이미 삭제되었다면 earliest offset 역시 변경된다.
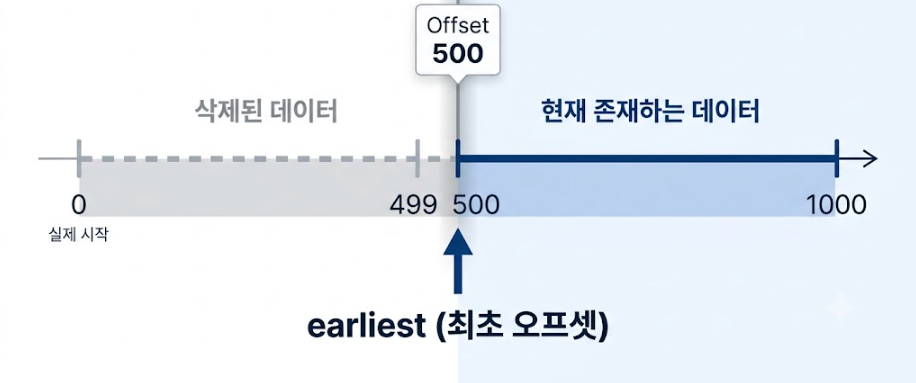
때문에 위 상황에서 --to-earliest를 수행하면 Offset 0이 아니라 Offset 500으로 설정된다. 즉, Producer를 먼저 신규 Cluster로 전환하고 Consumer를 나중에 옮기는 방식을 사용한다면 신규 Topic에 설정되어 있는 retention 역시 함께 확인해야 한다. Consumer 이관이 너무 늦어져 메시지가 retention에 의해 삭제되었다면 earliest 옵션으로도 해당 데이터를 다시 살릴 수 없다.