같은 조회인데 왜 동작이 다를까?
JPA 조회에서 발견한 차이
JPA를 사용하면서 Query Log를 보다가 내 예상과 다른 부분을 발견했다. 아래처럼 같은 findByEmail()을 연속해서 두 번 호출하는 코드가 있다고 가정해보자.
@Transactional
public void test(String email) {

    Member member1 =
        memberRepository.findByEmail(email)
            .orElseThrow();

    Member member2 =
        memberRepository.findByEmail(email)
            .orElseThrow();
}
두 메서드는 같은 Transaction 안에서 실행되고 있고 조회 조건도 완전히 동일하다. 첫 번째 findByEmail()에서 조회한 Member는 이미 영속성 컨텍스트에 들어가 있을 테니, 두 번째 조회에서는 Query가 발생하지 않을 거라고 생각했다.
하지만 예상과 달리 쿼리 로그를 확인해보니 SELECT Query가 두 번 발생하고 있었다. 그렇다면 첫 번째 findByEmail()에서 이미 Member가 영속성 컨텍스트에 들어갔을 텐데, 왜 두 번째 findByEmail()에서도 다시 SELECT Query가 발생하는 걸까? 혹시 내가 알고 있던 1차 캐시의 동작 방식과 실제 동작에는 차이가 있는 건지 궁금해졌다. 그래서 먼저 익숙하게 사용하던 findById()도 동일하게 두 번 호출해봤다.
findById 실행
이번에는 동일하게 findById()를 두 번 호출해봤다.
@Transactional
public void test(Long memberId) {

    Member member1 =
        memberRepository.findById(memberId)
            .orElseThrow();

    Member member2 =
        memberRepository.findById(memberId)
            .orElseThrow();
}
이 경우에는 예상했던 것처럼 SELECT Query가 한 번만 발생했다. 즉, 두 번째 findById()에서는 별도의 SELECT Query가 발생하지 않았다.
같은 Transaction 안에서 결국 같은 Member를 조회하는 코드인데 왜 이런 차이가 생기는 걸까? 이 부분이 궁금해서 내부 동작을 조금 더 찾아봤다.
findById는 Derived Query가 아니다
Derived Query
Spring Data JPA는 메서드 이름을 기반으로 필요한 쿼리를 자동으로 생성한다. 이러한 방식을 Derived Query(파생 쿼리)라고 한다.
Spring Data JPA 공식 문서에서도 findByEmailAddressAndLastname(...) 같은 Repository Method를 메서드명으로부터 JPQL Query로 생성한다고 설명하고 있다.
Derived Query는 어떻게 동작할까?
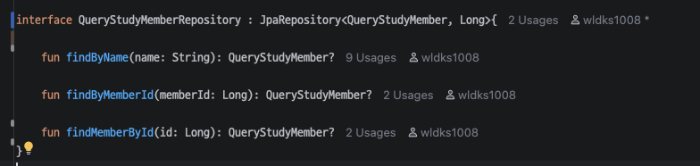
위의 사진 속 메서드들은 우리가 직접 Repository에 선언한 메서드다. 즉, 이 메서드는 CrudRepository에 미리 구현된 Reserved Method가 아니다. 때문에 Spring Data JPA가 메서드 이름을 분석해서 Query를 생성한다.
그런데 여기서 한 가지 헷갈릴 수 있는 부분이 있다. 우리가 자주 사용하는 findById(id)는 Derived Query일까?
이름만 보면 이 메서드 역시 findBy~ 형태이고, 별도의 쿼리를 작성하지 않아도 쿼리가 자동으로 생성되므로 Derived Query처럼 보인다. 하지만 findById()는 일반적인 Derived Query가 아니다.
Spring Data의 Reserved Method
findById()는 우리가 Repository에 직접 정의하는 메서드가 아니다. JpaRepository가 상속하는 CrudRepository에 선언되어 있고, 그 구현체인 SimpleJpaRepository에 이미 구현되어 있는 메서드이다. Spring Data에서는 이런 메서드를 Reserved Method(예약 메서드)로 구분한다. 대표적으로 다음과 같은 메서드가 있다.
- findById(...)
- existsById(...)
- deleteById(...)
- deleteAllById(...)
- findAllById(...)
findById(ID identifier) 같은 Reserved Method는 메서드에 쓰인 프로퍼티 이름과 상관없이 도메인의 식별자(Identifier) 프로퍼티를 대상으로 동작한다. 또한 메서드 이름을 분석해 쿼리를 만드는 일반적인 Query Derivation 메서드와 달리, Repository 프록시가 실제 구현체(JPA에서는 SimpleJpaRepository)의 메서드를 직접 호출한다. 따라서 이름에 findBy가 들어간다고 해서 무조건 Derived Query라고 볼 수는 없다. 이름은 비슷해도 실행 경로가 완전히 다르다.
findById의 내부 구현
Spring Data JPA의 기본 Repository 구현체는 SimpleJpaRepository다. findById()의 구현을 따라가 보면 내부에서 JPQL을 생성하지 않는다.

위 코드에서 볼 수 있듯, findById의 내부 구현은 EntityManager.find()라는 JPA API를 직접 사용한다. 이 차이가 1차 캐시와 바로 연결되는 핵심 코드이다.
✎ EntityManager.find()와 1차 캐시
EntityManager.find()는 Primary Key를 기준으로 Entity를 조회한다. 따라서 메서드를 호출하는 시점에 어떤 Entity를 찾는지 정확히 알 수 있고, Hibernate는 이를 이용해 DB에 SELECT 쿼리를 보내기 전에 Persistence Context를 먼저 확인할 수 있다.

같은 Persistence Context 안에서 첫 번째 findById(1L)로 Member#1이 이미 등록되었다면, memberRepository.findById(1L)을 다시 호출해도 DB에 접근할 필요가 없다. findById()를 연속으로 호출했을 때 SELECT 쿼리가 한 번만 발생한 이유가 바로 이것이다.
왜 Derived Query는 1차 캐시만 보고 끝낼 수 없을까?
여기서 다시 처음 궁금했던 내용으로 돌아가보자.
memberRepository.findByEmail("test@test.com");
memberRepository.findByEmail("test@test.com");
첫 번째 Query에서 이미 Member를 찾았다면 두 번째에도 그 Entity를 사용하면 되지 않을까? 문제는 1차 캐시가 무엇을 기준으로 데이터를 관리하느냐에 있다. Hibernate는 Persistence Context 안에서 Entity를 EntityKey 기준으로 관리한다. 즉, 1차 캐시는 “한번 실행했던 Query를 기억하는 캐시”가 아니라 “현재 Persistence Context에서 관리하고 있는 Entity를 식별자 기준으로 관리하는 캐시”라고 볼 수 있다.
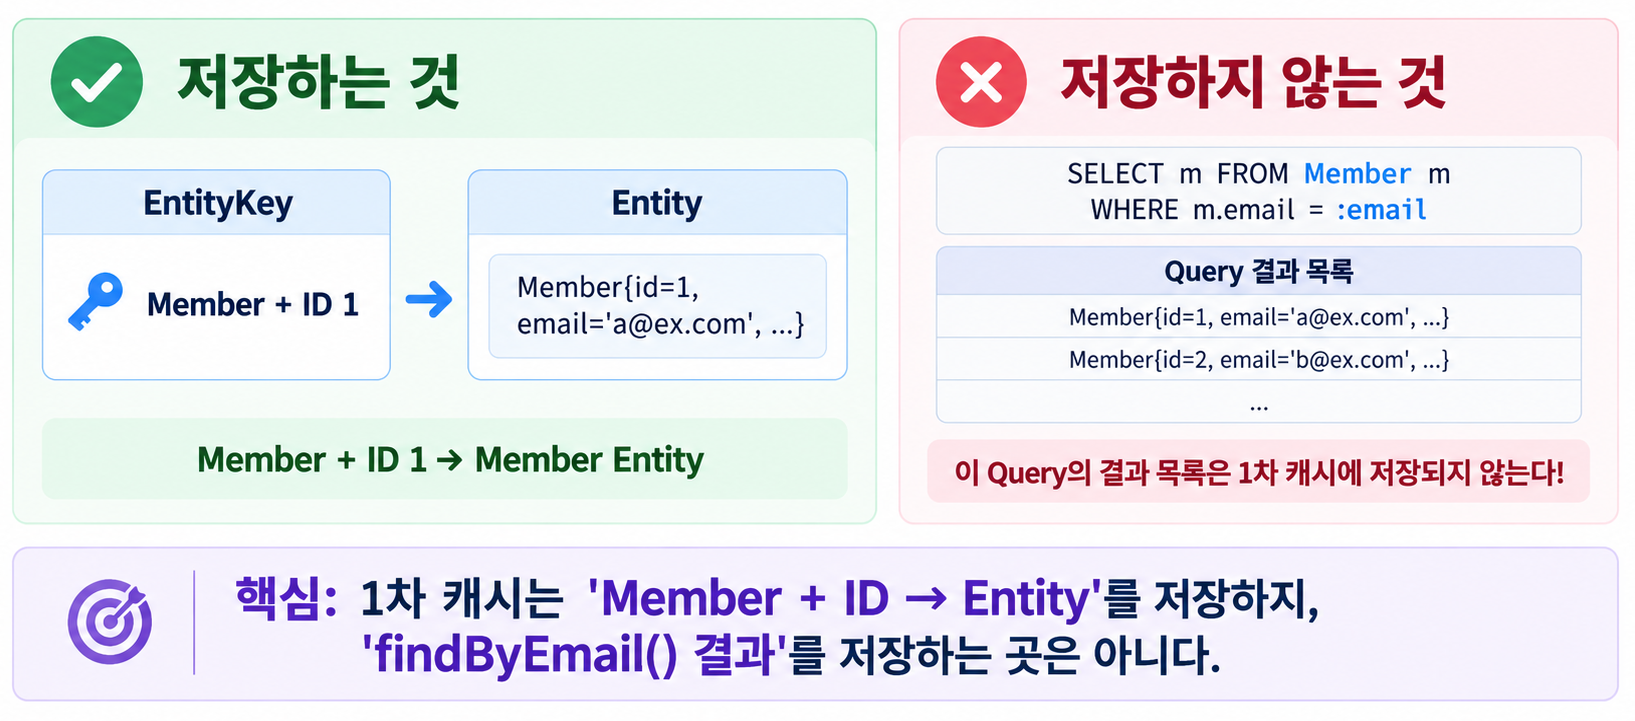
첫 번째 findByEmail()이 끝나면 Member#1이 Persistence Context에 등록된다. 하지만 1차 캐시는 email = 'test@test.com'이라는 쿼리 조건과 그 결과까지 기억하지는 않는다. 따라서 두 번째 findByEmail()을 호출해도 쿼리는 다시 실행된다.
여기서 흥미로운 점이 하나 더 있다. SELECT 쿼리는 두 번 발생하지만, 두 쿼리가 반환하는 Entity는 같은 객체다. 두 번째 쿼리에서 다시 id = 1인 Row를 얻더라도, Hibernate는 Member#1이 이미 Persistence Context에 있다는 것을 알고 있으므로 새 객체를 만들지 않고 기존 객체를 반환하기 때문이다.
즉, "SELECT 쿼리가 발생한다"와 "Persistence Context를 사용하지 않는다"는 같은 의미가 아니다. Derived Query는 조건을 만족하는 Row를 찾기 위해 DB에 쿼리를 실행하지만, 그 결과를 Entity로 관리할 때는 여전히 Persistence Context를 사용한다.
마무리
JPA를 사용하다 보면 익숙하게 쓰던 기능도 내부 동작을 조금만 들여다보면 생각하지 못했던 부분이 꽤 많이 나온다. 직접 Query를 작성하지 않아도 될 만큼 편리한 대신, 내부 구현을 잘 모르고 사용하면 예상과 다른 동작을 만날 수도 있다. 특히 이런 차이는 단순한 코드 레벨을 넘어서 실제 운영 환경의 Query 수나 성능에도 영향을 줄 수 있기 때문에, 자주 사용하는 기능일수록 한 번쯤 내부 동작을 확인해보는 것도 좋은 것 같다.
이번 글에서 다룬 내용에 더하여 좀 더 다양한 상황을 추가적으로 담아 작성한 코드는 GitHub에 정리해두었다. 글로만 보는 것보다 직접 실행하면서 Query Log를 비교해보면 findById()와 Derived Query의 차이가 조금 더 명확하게 보일 것 같다.
'JPA&JDBC' 카테고리의 다른 글
| JPA Attribute Converter란? (0) | 2026.07.25 |
|---|---|
| Hibernate Envers - 간편하게 엔티티 변경 이력 관리하기 (0) | 2026.05.03 |
| JpaPagingItemReader의 transacted 옵션 (0) | 2026.04.05 |
| [JPA] 실전! 스프링 데이터 JPA - 섹션 6~8 (0) | 2025.03.17 |
| [JPA] 실전! 스프링 데이터 JPA - 섹션 1~5 (0) | 2025.03.17 |