들어가며
최근에 하나의 서버 인스턴스에서 서로 다른 주기로 동작하는 Scheduler를 개발 배포 후, 운영하던 중에 이상한 현상을 발견했다.
예를 들어 다음과 같이 두 개의 Scheduler가 있다고 해보자.
@Scheduled(cron = "0 0 * * * *")
fun firstJob() {
    // ...
}

@Scheduled(cron = "0 30 * * * *")
fun secondJob() {
    // ...
}
firstJob은 매시 정각에 실행되고, secondJob은 매시 30분에 실행된다. 평소에는 firstJob이 10~20분 정도 걸렸기 때문에 별다른 문제가 없었다. 그런데 처리해야 하는 데이터가 많아지면서 firstJob의 수행 시간이 30분을 넘어가기 시작했고, 이때 30분에 실행되어야 하는 secondJob까지 같이 늦게 실행되는 현상이 발생했다. 예를 들어 다음과 같은 식이었다.
- 01:00 firstJob start
- 01:43 firstJob end
- 01:43 secondJob start
secondJob은 분명 01:30에 실행되도록 설정되어 있는데 실제로는 13분이 지난 01:43에 실행됐다. 처음에는 secondJob 자체에서 DB Lock이나 Connection 획득 때문에 지연이 발생하는 것인가 싶었다. 그런데 로그에 Thread 이름을 함께 남겨보니 조금 이상한 점이 보였다.
01:00 firstJob start  | thread=scheduling-1
01:43 firstJob end    | thread=scheduling-1
01:43 secondJob start | thread=scheduling-1
두 Scheduler가 같은 Thread에서 실행되고 있었다. 그리고 secondJob은 우연히 늦게 실행된 것이 아니라 정확하게 firstJob이 끝난 이후 실행되고 있었다. 여기서 한 가지 의문이 생겼다. Spring Scheduler는 기본적으로 Single Thread로 동작하는 걸까?
이번 글에서는 @Scheduled가 내부적으로 어떻게 등록되고 실행되는지 살펴보고, Scheduler의 Thread를 커스텀하는 방법까지 정리해보려고 한다.
@Scheduled는 어떻게 실행될까?
보통 Spring에서 Scheduler를 사용할 때는 @EnableScheduling을 활성화한다.
@Configuration
@EnableScheduling
class SchedulerConfiguration
그리고 실행할 메서드에 @Scheduled를 붙인다.
@Scheduled(cron = "0 0 * * * *")
fun execute() {
    // ...
}
사용하는 입장에서는 @EnableScheduling 하나만 추가하면 끝이지만, 내부에서는 @Scheduled가 붙은 메서드를 찾아 실제 Scheduler에 등록하는 과정이 필요하다. 이 과정의 시작점인 @EnableScheduling은 내부적으로 SchedulingConfiguration을 Import하는데, 이 설정 클래스가 하는 일은 @Scheduled를 처리하는 ScheduledAnnotationBeanPostProcessor를 Bean으로 등록하는 것이 전부다. Spring 공식 문서에서도 SchedulingConfiguration이 이 BeanPostProcessor를 등록하며, @EnableScheduling을 사용하면 자동으로 Import된다고 설명한다. 전체 흐름을 간단하게 표현하면 다음과 같다.
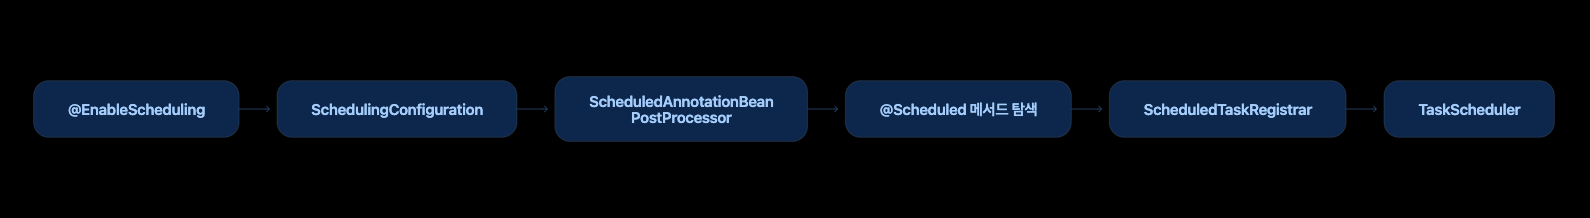
그렇다면 하나씩 살펴보자.
ScheduledAnnotationBeanPostProcessor
이름이 굉장히 길지만 역할은 비교적 명확하다. ScheduledAnnotationBeanPostProcessor는 Bean을 확인하면서 @Scheduled가 선언된 메서드를 찾고, 해당 메서드가 설정된 주기에 실행될 수 있도록 Task로 등록한다. 그리고 이렇게 만들어진 Task들을 관리하고 실제 Scheduler에 등록하는 역할을 ScheduledTaskRegistrar가 담당한다. 여기서 중요한 것은 @Scheduled가 직접 Thread를 만들고 작업을 실행하는 것은 아니라는 점이다. @Scheduled에는 "언제 실행할 것인가?"에 대한 정보가 담겨 있고, 실제로 해당 작업을 실행하는 주체는 TaskScheduler이다. 그러면 결국 처음 발생했던 문제를 확인하려면 어떤 TaskScheduler가 사용되고 있는지를 확인해야 한다.
TaskScheduler는 어떻게 결정될까?
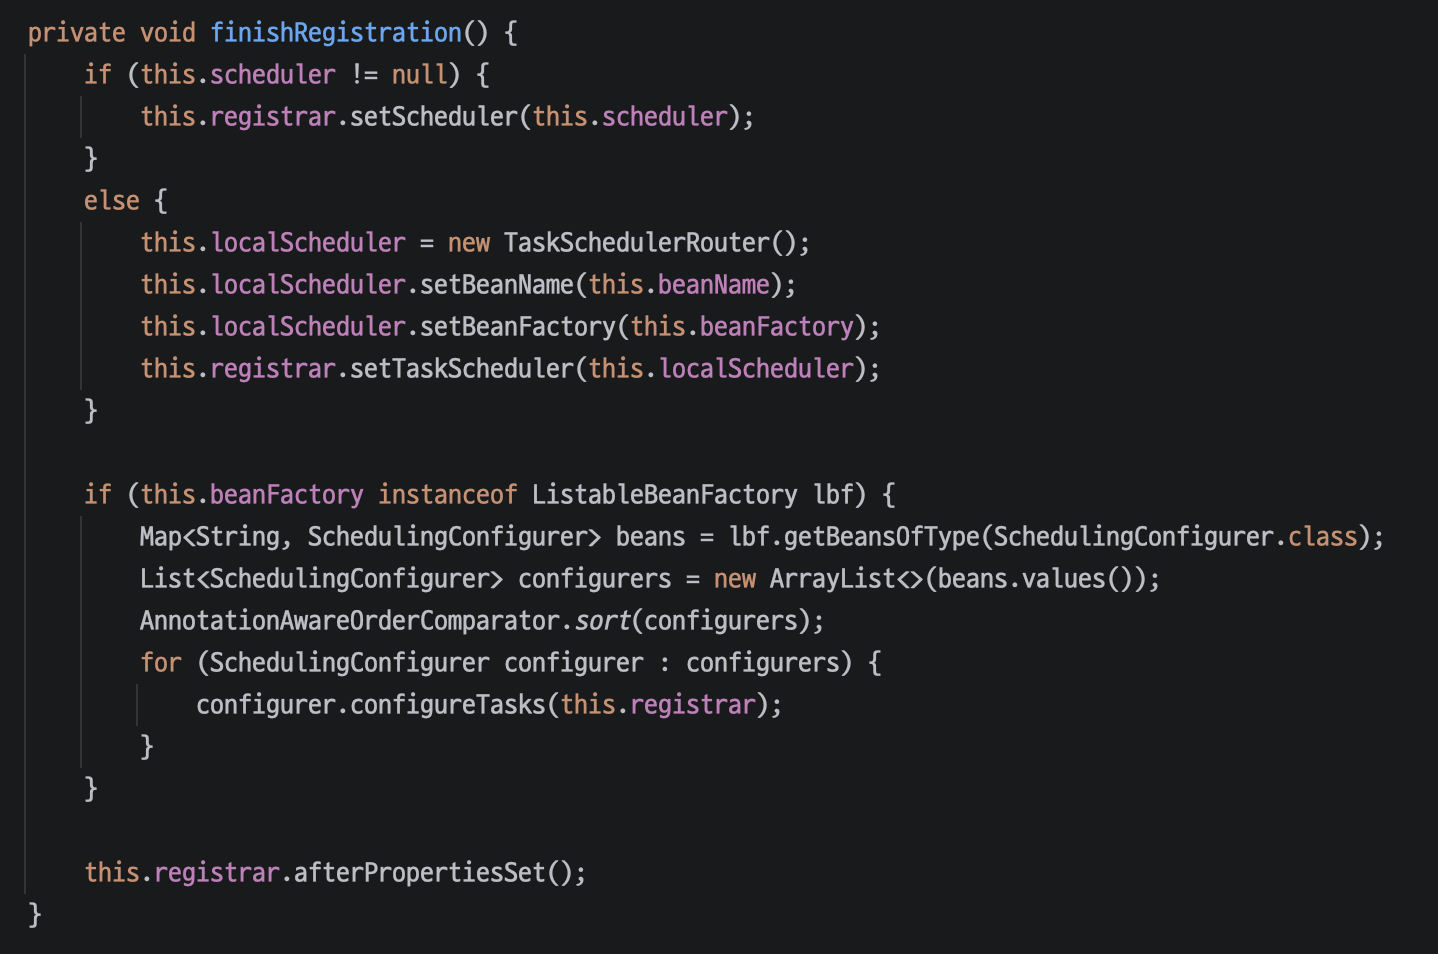
ScheduledAnnotationBeanPostProcessor는 finishRegistration()에서 @Scheduled 작업을 실행할 Scheduler를 정한다. 직접 지정한 Scheduler가 있으면 그것을 쓰고, 없으면 TaskSchedulerRouter를 만들어 ScheduledTaskRegistrar에 설정한다.
TaskSchedulerRouter는 무슨 역할일까?
Router는 작업을 직접 실행하지 않는다. 각 작업을 어느 Scheduler에 맡길지 골라서 전달하는 접수 창구다. Spring 6.1부터 @Scheduled마다 사용할 Scheduler를 지정할 수 있어서 이런 중계 역할이 필요해졌다.
@Scheduled(fixedRate = 1000, scheduler = "myScheduler")  // 지정한 Scheduler 사용
public void taskA() { ... }

@Scheduled(fixedRate = 1000)                             // 지정 안 함 → 기본 Scheduler 사용
public void taskB() { ... }
지정하지 않으면 기본 Scheduler는 어떻게 찾을까? scheduler를 지정하지 않은 작업은 다음 순서로 Scheduler를 찾는다.
- TaskScheduler Bean이 하나뿐이면 그 Bean
- 여러 개면 이름이 taskScheduler인 Bean
- 없으면 ScheduledExecutorService를 같은 방식으로 검색
- 그래도 없으면 Spring이 만든 스레드 1개짜리 기본 Scheduler
처음 가졌던 의문, 곧 왜 @Scheduled 작업들이 동시에 실행되지 않고 하나씩 실행되는 것처럼 보이는가에 대한 답이 여기 있다. 아무 설정도 하지 않으면 4번까지 내려가고, 스레드가 하나뿐이라 앞 작업이 오래 걸리면 뒤 작업이 밀린다. 그렇다고 Spring Scheduler가 Single Thread인 것은 아니다. 4번은 1~3번에서 아무것도 찾지 못했을 때 쓰는 최후의 대비책(fallback)일 뿐이다. TaskScheduler Bean을 등록해서 스레드 수를 늘리면 여러 작업이 동시에 실행된다.
ThreadPoolTaskScheduler의 기본 Pool Size는 1이다
Spring은 Scheduler를 TaskScheduler 인터페이스로 추상화하며, 어떤 구현체를 쓰느냐에 따라 작업이 실행되는 방식이 달라진다. 대표적인 구현체가 ThreadPoolTaskScheduler다. Spring Boot는 Virtual Thread를 활성화하지 않은 일반적인 환경에서 이 ThreadPoolTaskScheduler를 자동으로 구성해 준다. 그런데 이름에는 ThreadPool이 들어가지만, 기본값은 의외다. 소스를 보면 poolSize의 기본값이 1이다.
private volatile int poolSize = 1;
ThreadPoolTaskScheduler의 Javadoc에도 기본 Scheduler Thread 수는 1이며, setPoolSize()로 늘릴 수 있다고 명시되어 있다. Spring Boot의 설정도 같아서, spring.task.scheduling.pool.size의 기본값 역시 1이다.
따라서 별다른 설정 없이 사용했다면 다음과 같은 구조가 된다.
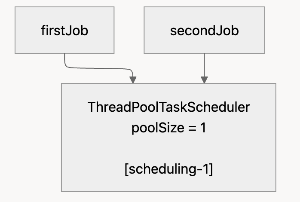
Task는 두 개지만 실제로 작업을 수행할 수 있는 Thread는 하나뿐이다. 두 작업이 같은 시간에 실행되도록 설정해 두어도 하나가 끝나야 다른 하나가 시작된다.
처음 상황으로 돌아가보자. 01:00에 firstJob이 실행됐다. 원래대로라면 01:30에 secondJob이 실행되어야 한다. 그런데 이때 firstJob이 아직 끝나지 않았다.
ThreadPoolTaskScheduler는 내부적으로 ScheduledThreadPoolExecutor를 사용하고, Task 실행 자체가 Scheduler Thread에서 이루어진다. 별도의 Worker Thread로 다시 넘겨주는 구조가 아니다. 따라서 Pool Size가 1이라면 firstJob을 실행하고 있는 동안 다른 Scheduler Task를 동시에 실행할 수 없다. 결국 01:43에 firstJob이 끝나고 나서야 실행할 Thread가 비게 된다.
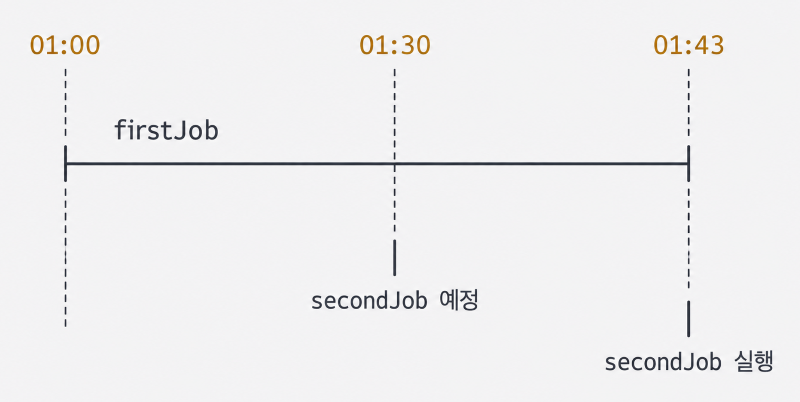
즉, 실행할 수 있는 Thread를 기다리느라 시작 자체가 13분 늦어진 것이다.
해결해보자
1. 설정 파일 변경
원인을 알았으니 해결 방법은 비교적 간단하다. Scheduler가 사용할 수 있는 Thread를 늘리면 된다. Spring Boot에서는 설정만으로 변경할 수 있다.
spring:
  task:
    scheduling:
      pool:
        size: 5
별도 설정이 없으면 스레드 1개로 동작하지만, 이는 기본값일 뿐이다. Scheduler Bean을 등록하거나 스레드 풀 크기를 설정하면 얼마든지 멀티 스레드로 동작하게 만들 수 있다. 이때, 해당 스레드 풀 크기 설정값은 spring.task.scheduling.pool.size로 이를 조정할 수 있다.
Pool Size를 5로 설정하게 된다면, firstJob이 실행되고 있더라도 유휴 상태인 다른 Thread에서 secondJob을 실행할 수 있다. 따라서 두 작업은 다음과 같이 겹쳐서 실행될 수 있는 것이다. 단순히 여러 @Scheduled 작업을 병렬로 실행하는 것이 목적이라면 이 방법이 가장 간단하다.
번외) Thread Pool Size 설정 시 고려할 점
Scheduler Thread가 20개인데 DB Connection Pool은 10개라고 해 보자. Scheduler가 20개의 작업을 동시에 실행하더라도, DB Connection이 필요한 작업이라면 실제로 DB에 접근할 수 있는 작업은 10개뿐이다. 나머지 10개의 Thread는 Connection이 반환되기를 기다리게 된다.
외부 API를 호출하는 작업도 마찬가지다. 상대 서버의 Rate Limit이나 HTTP Connection Pool 같은 다른 자원의 제한을 받을 수 있다.
따라서 Scheduler의 Pool Size는 "작업 개수 = Thread 개수"처럼 단순하게 정하기보다, 각 작업의 수행 시간과 실행 주기, 그리고 작업 내부에서 사용하는 자원까지 함께 고려해서 정하는 것이 좋다.
2. TaskScheduler를 직접 설정하기
Property가 아니라 Scheduler 자체를 직접 Bean으로 등록할 수도 있다.
@Configuration
@EnableScheduling
public class SchedulerConfiguration {

    @Bean
    public TaskScheduler taskScheduler() {
        ThreadPoolTaskScheduler scheduler = new ThreadPoolTaskScheduler();
        scheduler.setPoolSize(5);
        scheduler.setThreadNamePrefix("my-scheduler-");
        return scheduler;
    }
}
TaskScheduler Bean을 직접 등록하면 Spring Boot가 자동으로 구성하는 Scheduler 대신 이 Bean이 사용된다. 위 설정에서는 ThreadPoolTaskScheduler의 풀 크기를 5로 지정했으므로 최대 5개의 작업을 동시에 실행할 수 있다. setThreadNamePrefix()로 지정한 접두사는 스레드 이름에 반영되어(my-scheduler-1, my-scheduler-2 ...), 로그에서 어떤 스레드가 작업을 실행했는지 확인하기 쉽다.
3. SchedulingConfigurer 커스텀
Scheduler를 조금 더 명시적으로 설정하고 싶다면 SchedulingConfigurer를 이용하는 방법도 있다.
@Configuration
@EnableScheduling
class SchedulerConfiguration : SchedulingConfigurer {

    override fun configureTasks(taskRegistrar: ScheduledTaskRegistrar) {
        taskRegistrar.setTaskScheduler(taskScheduler())
    }

    @Bean
    fun taskScheduler(): ThreadPoolTaskScheduler =
        ThreadPoolTaskScheduler().apply {
            poolSize = 4
            setThreadNamePrefix("scheduler-")
        }
}
앞에서 본 ScheduledAnnotationBeanPostProcessor.finishRegistration()은 기본 Scheduler를 설정한 뒤 컨테이너에서 SchedulingConfigurer Bean을 찾아 configureTasks()를 호출한다. 이때 Task 등록을 담당하는 ScheduledTaskRegistrar를 넘겨 주므로, 이 안에서 사용할 Scheduler를 지정하면 기본 설정 대신 우리가 지정한 Scheduler가 사용된다.
다만 위 예시처럼 TaskScheduler Bean이 하나뿐이라면 SchedulingConfigurer 없이도 Spring이 그 Bean을 찾아 사용한다. SchedulingConfigurer의 진짜 장점은 ScheduledTaskRegistrar를 통해 Scheduler를 명시적으로 지정하거나, @Scheduled 없이 Task를 코드로 직접 등록할 수 있다는 점이다.
4. Scheduler 자체를 분리
그런데 Pool Size를 늘리는 것으로 항상 충분할까? 두 작업을 같은 Thread Pool에 넣어놓으면 Pool Size를 늘렸더라도 Batch 작업이 Thread를 많이 점유하면서 다른 Scheduler에 영향을 줄 가능성이 있다. 이 경우에는 아예 Scheduler 자체를 분리할 수도 있다.
Spring Framework 6.1부터 @Scheduled에는 사용할 Scheduler를 지정하는 scheduler 속성이 추가되었다.
먼저 각각의 Scheduler를 Bean으로 등록한다.
@Bean
fun batchScheduler(): ThreadPoolTaskScheduler =
    ThreadPoolTaskScheduler().apply {
        poolSize = 2
        setThreadNamePrefix("batch-scheduler-")
    }

    @Bean
    fun monitoringScheduler(): ThreadPoolTaskScheduler =
        ThreadPoolTaskScheduler().apply {
        	poolSize = 1
            setThreadNamePrefix ("monitoring-scheduler-")
        }
그리고 @Scheduled에서 사용할 Scheduler를 지정한다.
@Scheduled(
    cron = "0 0 * * * *",
    scheduler = "batchScheduler",
)
fun batchJob() {
    // ...
}

@Scheduled(
    cron = "0 30 * * * *",
    scheduler = "monitoringScheduler",
)
fun monitoringJob() {
    // ...
}
이제 두 작업은 같은 Thread Pool을 공유하지 않는다. 중요한 작업끼리 서로 영향을 주면 안 되는 경우라면 단순히 Pool Size를 크게 설정하는 것보다 이런 식으로 실행 자원 자체를 분리하는 방법도 고려할 수 있다.
'Spring' 카테고리의 다른 글
| [Spring Batch] Spring Batch 아키텍쳐와 전체 흐름 이해하기 (1) | 2026.04.19 |
|---|---|
| [EduKit] 사용자 경험을 개선해보자 (feat. Tomcat NIO) (0) | 2025.08.14 |
| 이벤트 기반 처리로 구현하는 회원가입 및 이메일 전송 (feat. Thread pool) (0) | 2025.06.11 |
| 재시도 폭풍에서 서버를 지키는 방법 (feat. 동시성 문제) (2) | 2025.05.21 |
| 로그인 코드 리팩토링 대장정 (0) | 2025.03.19 |